
TRL documentation
TRL - Transformers Reinforcement Learning

TRL - Transformers Reinforcement Learning
TRL là một thư viện full stack, cung cấp một bộ công cụ để huấn luyện các mô hình ngôn ngữ transformer bằng các phương pháp như Supervised Fine-Tuning (SFT), Group Relative Policy Optimization (GRPO), Direct Preference Optimization (DPO), Reward Modeling và nhiều hơn nữa. Thư viện này được tích hợp với 🤗 transformers.
🎉 Điểm mới
⚡ AsyncGRPOTrainer đã ổn định: AsyncGRPOTrainer chính thức trở thành API ổn định. Nó chạy GRPO nhanh hơn nhiều bằng cách tách rời quá trình sinh ra khỏi quá trình huấn luyện: một máy chủ vLLM sẽ phát trực tiếp các rollout trong khi trainer cập nhật mô hình.
Phân loại
Dưới đây là tổng quan về các trình huấn luyện TRL, được sắp xếp theo mức độ hoàn thiện và loại phương pháp.
Thử nghiệm
Bạn cũng có thể khám phá các mô hình, bộ dữ liệu và demo liên quan đến TRL trong tổ chức TRL trên Hugging Face.
Học
Học hậu huấn luyện với TRL và các thư viện khác trong 🤗 smol course.
Nội dung
Tài liệu được tổ chức thành các phần sau:
- Bắt đầu: hướng dẫn cài đặt và khởi động nhanh.
- Hướng dẫn khái niệm: định dạng tập dữ liệu, câu hỏi thường gặp về huấn luyện và cách hiểu nhật ký.
- Hướng dẫn: giảm mức sử dụng bộ nhớ, tăng tốc huấn luyện, phân phối huấn luyện, v.v.
- Tích hợp: DeepSpeed, PEFT, v.v.
- Ví dụ: tổng quan về ví dụ, hướng dẫn của cộng đồng, v.v.
- API: trainers, utils, v.v.
Bài viết trên blog
Được xuất bản vào ngày 27 tháng 5 năm 2026
Phân phối một nghìn tỷ tham số với một Bucket trên Hub: Đồng bộ hóa trọng số Delta trong TRL

Được xuất bản vào ngày 31 tháng 3 năm 2026
TRL v1: Thư viện huấn luyện sau giữ vững khi lĩnh vực này phủ nhận chính các giả định của nó
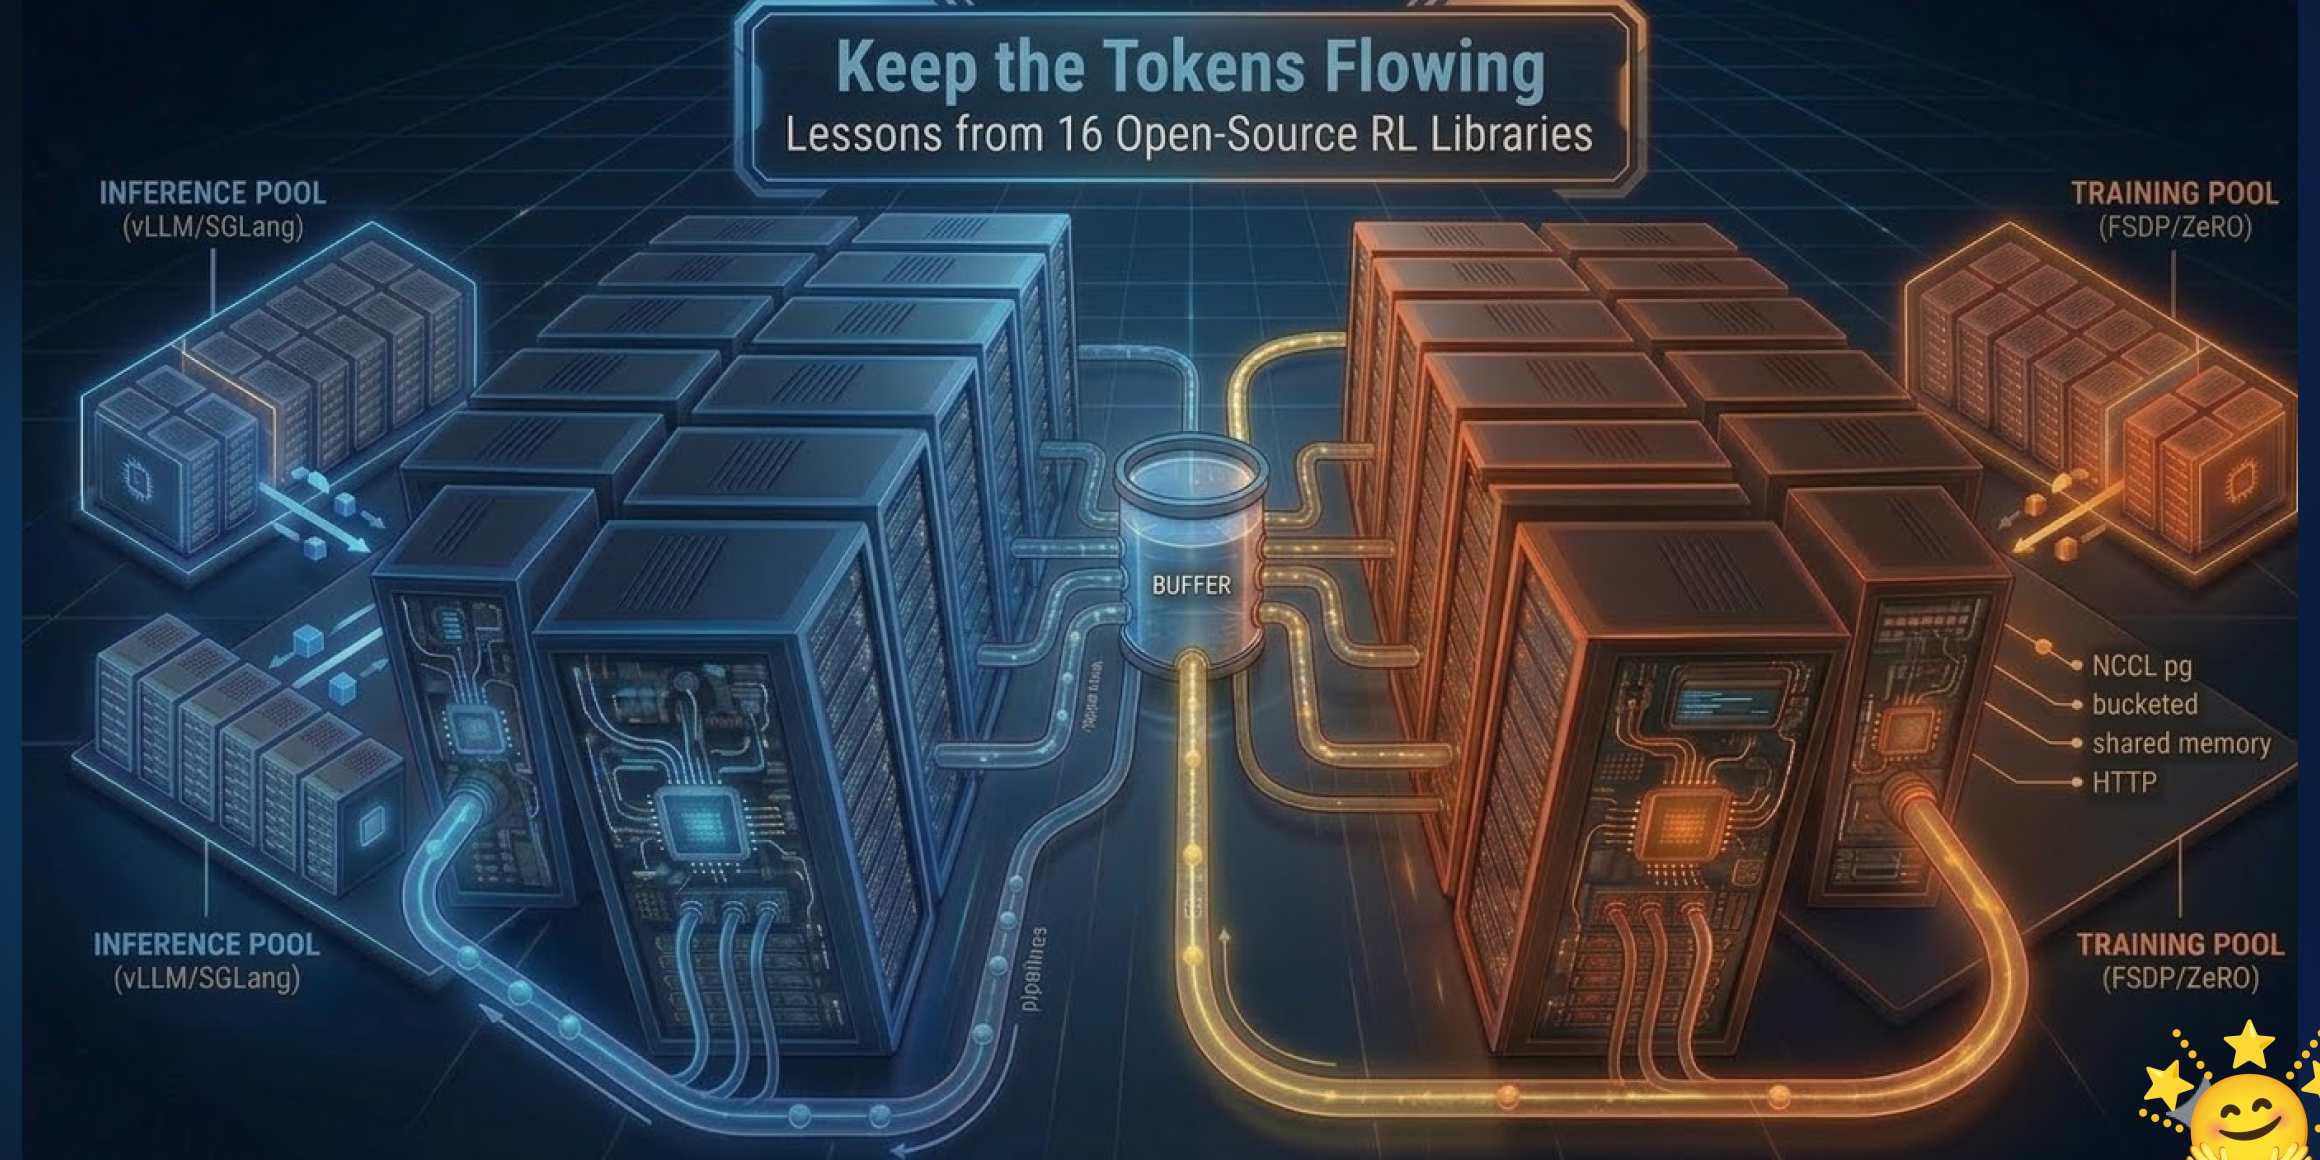
Được xuất bản vào ngày 10 tháng 3 năm 2026
Giữ cho các Token Tiếp Tục Chảy: Bài Học Từ 16 Thư Viện RL Mã Nguồn Mở
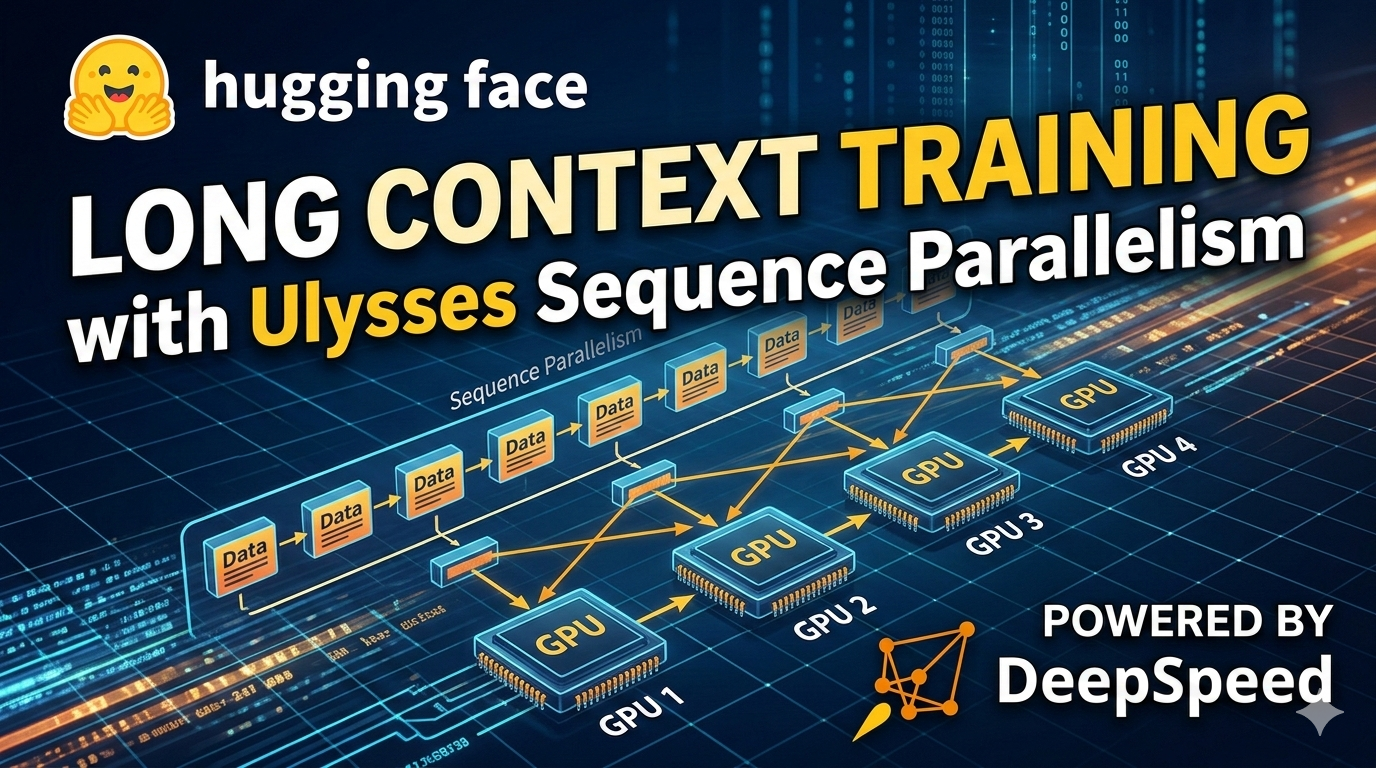
Được xuất bản vào ngày 9 tháng 3 năm 2026
Ulysses Sequence Parallelism: Huấn luyện với ngữ cảnh hàng triệu token
Được xuất bản ngày 23 tháng 10 năm 2025
Cùng xây dựng hệ sinh thái Open Agent: Giới thiệu OpenEnv
Được xuất bản vào ngày 7 tháng 8 năm 2025
Căn chỉnh Mô hình Ngôn ngữ Thị giác trong TRL ⚡️
Được xuất bản vào ngày 3 tháng 6 năm 2025
Không GPU nào bị bỏ lại phía sau: Khai phá hiệu suất với vLLM đồng vị trí trong TRL
Được xuất bản vào ngày 25 tháng 5 năm 2025
🐯 Liger GRPO gặp TRL
Được xuất bản vào ngày 28 tháng 1 năm 2025
Open-R1: bản tái tạo hoàn toàn mở của DeepSeek-R1
Được xuất bản vào ngày 10 tháng 7 năm 2024
Tối ưu hóa sở thích cho Mô hình Ngôn ngữ Thị giác với TRL
Được xuất bản vào ngày 12 tháng 6 năm 2024
Đưa RL trở lại RLHF
Được xuất bản vào ngày 10 tháng 1 năm 2024
Tăng tốc độ tinh chỉnh LLM gấp 2 lần với Unsloth và 🤗 TRL
Được xuất bản vào ngày 29 tháng 9 năm 2023
Finetune các mô hình Stable Diffusion bằng DDPO thông qua TRL
Được xuất bản vào ngày 8 tháng 8 năm 2023
Tinh chỉnh Llama 2 với DPO
Được xuất bản vào ngày 5 tháng 4 năm 2023
StackLLaMA: Hướng dẫn thực hành huấn luyện LLaMA với RLHF
Được xuất bản vào ngày 9 tháng 3 năm 2023
Tinh chỉnh các LLM 20B bằng RLHF trên GPU tiêu dùng 24GB
Được xuất bản vào ngày 9 tháng 12 năm 2022
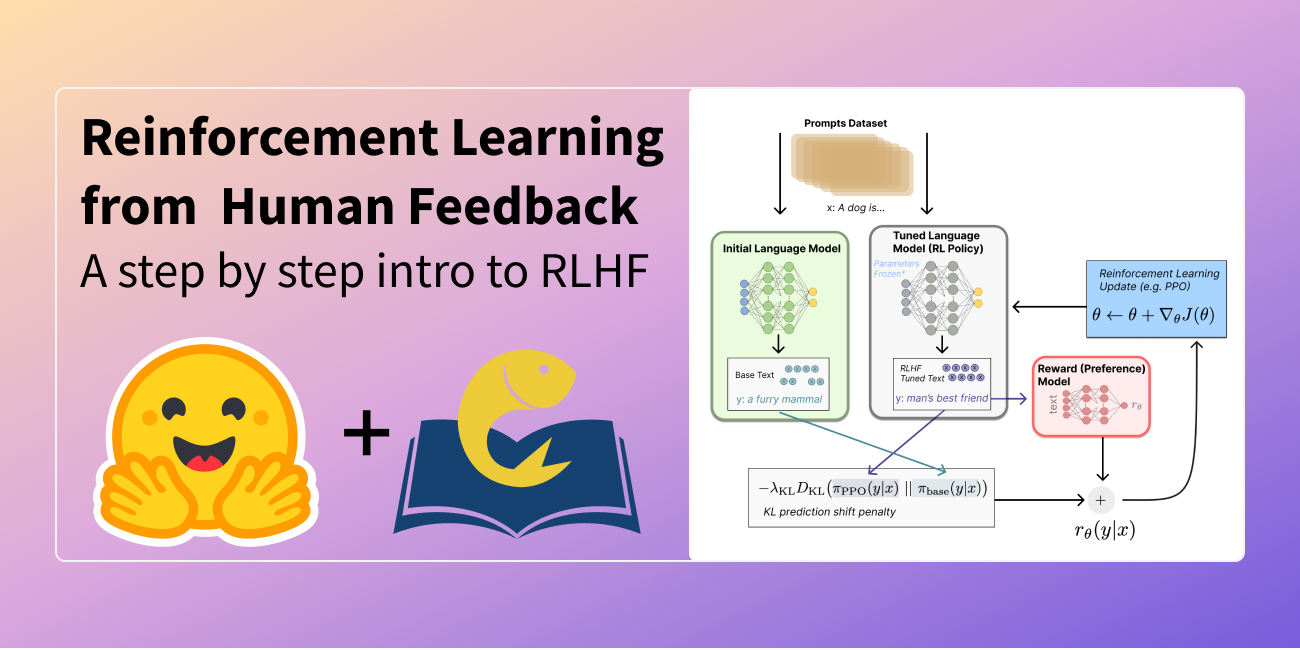
Minh họa Học tăng cường từ phản hồi của con người
