# ConvNeXT
## 概述
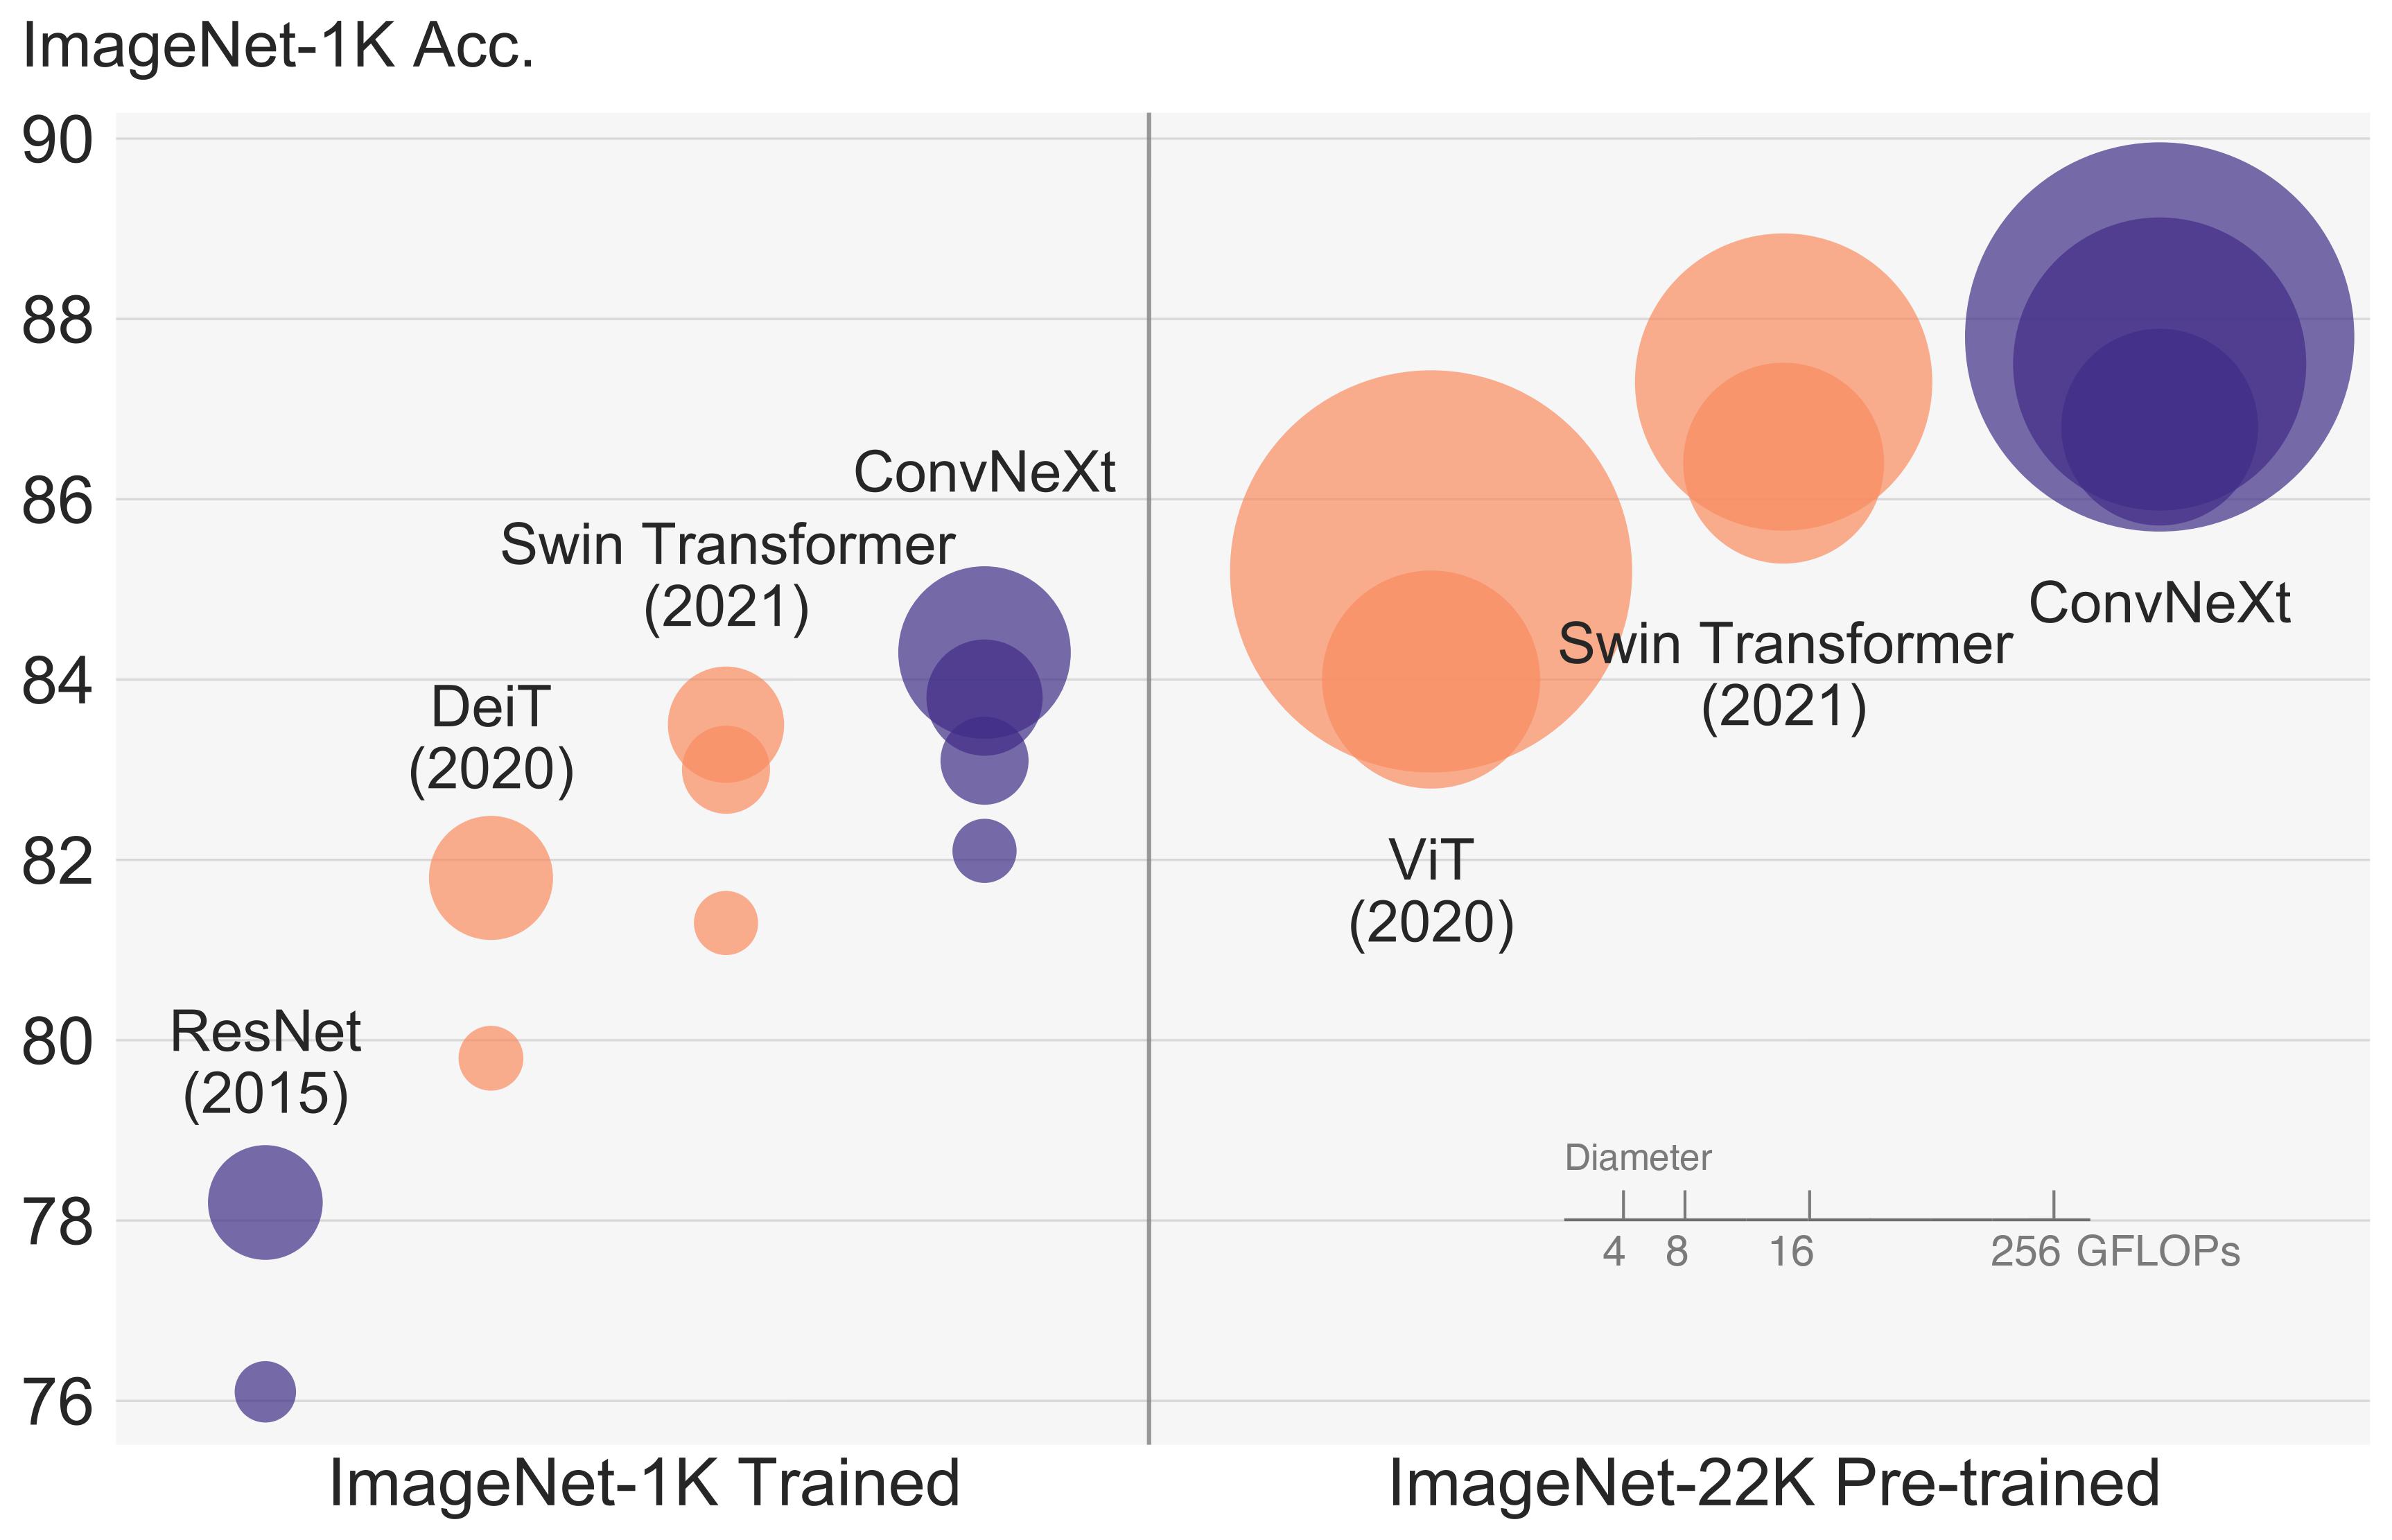
ConvNeXT 模型由 Zhuang Liu、Hanzi Mao、Chao-Yuan Wu、Christoph Feichtenhofer、Trevor Darrell 和 Saining Xie 在 [A ConvNet for the 2020s](https://huggingface.co/papers/2201.03545) 中提出。ConvNeXT 是一个纯卷积模型(ConvNet),其设计灵感来源于 Vision Transformers,并声称性能优于后者。
该论文的摘要如下:
*视觉识别领域的“咆哮的二十年代”始于视觉 Transformer(ViT)的引入,它迅速取代了 ConvNet,成为最先进的图像分类模型。然而,原始的 ViT 在应用于目标检测和语义分割等通用计算机视觉任务时面临困难。正是分层 Transformer(例如 Swin Transformer)重新引入了多个 ConvNet 先验,使 Transformer 实际上可以作为通用的视觉骨干网络,并在多种视觉任务上展现出卓越的性能。然而,这种混合方法的有效性在很大程度上仍被归功于 Transformer 的内在优越性,而非卷积固有的归纳偏置。在这项工作中,我们重新审视了设计空间,并测试了纯 ConvNet 所能达到的极限。我们逐步将标准 ResNet “现代化”,使其向视觉 Transformer 的设计靠拢,并在此过程中发现了若干导致性能差异的关键组件。这一探索的成果是一系列被称为 ConvNeXt 的纯 ConvNet 模型。ConvNeXt 完全由标准 ConvNet 模块构建,在准确率和可扩展性方面与 Transformer 不相上下,在 ImageNet 上达到了 87.8% 的 top-1 准确率,并在 COCO 检测和 ADE20K 分割上超越了 Swin Transformer,同时保持了标准 ConvNet 的简洁性和高效性。*
 ConvNeXT 架构。摘自原始论文。
该模型由 [nielsr](https://huggingface.co/nielsr) 贡献。原始代码可在[此处](https://github.com/facebookresearch/ConvNeXt)找到。
## 资源
一份来自 Hugging Face 官方和社区(以 🌎 标识)的资源列表,帮助你快速上手 ConvNeXT。
- [ConvNextForImageClassification](/docs/transformers/main/zh/model_doc/convnext#transformers.ConvNextForImageClassification) 受此 [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb) 支持。
- 另请参阅:[图像分类任务指南](../tasks/image_classification)
如果您有兴趣提交资源以收录在此处,请随时发起 Pull Request,我们将对其进行审核!理想情况下,该资源应展示一些新内容,而不是重复现有资源。
## ConvNextConfig[[transformers.ConvNextConfig]]
#### transformers.ConvNextConfig[[transformers.ConvNextConfig]]
```python
transformers.ConvNextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_channels: int = 3, patch_size: int | list[int] | tuple[int, int] = 4, num_stages: int = 4, hidden_sizes: list[int] | tuple[int, ...] | None = (96, 192, 384, 768), depths: list[int] | tuple[int, ...] | None = (3, 3, 9, 3), hidden_act: str = 'gelu', initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, layer_scale_init_value: float = 1e-06, drop_path_rate: float | int = 0.0, image_size: int | list[int] | tuple[int, int] = 224, _out_features: list[str] | None = None, _out_indices: list[int] | None = None)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/configuration_convnext.py#L25)
**参数:**
num_channels (`int`,*可选*,默认为 `3`):输入通道数。
patch_size (`Union[int, list[int], tuple[int, int]]`,*可选*,默认为 `4`):每个 patch 的大小(分辨率)。
num_stages (`int`,*可选*,默认为 4):模型中的阶段数。
hidden_sizes (`Union[list[int], tuple[int, ...]]`,*可选*,默认为 `(96, 192, 384, 768)`):模型每个阶段的维度(隐藏层大小)。
depths (`Union[list[int], tuple[int, ...]]`,*可选*,默认为 `(3, 3, 9, 3)`):Transformer 中每一层的深度。
hidden_act (`str`,*可选*,默认为 `gelu`):解码器中的非线性激活函数(函数或字符串)。例如,`"gelu"`、`"relu"`、`"silu"` 等。
initializer_range (`float`,*可选*,默认值为 `0.02`):用于初始化所有权重矩阵的 truncated_normal_initializer 的标准差。
layer_norm_eps (`float`, *可选*,默认为 `1e-12`):层归一化层所使用的 epsilon。
layer_scale_init_value (`float`, *可选*, 默认为 `1e-06`) : 在自注意力层中使用的缩放比例。基础模型为 0.1,大型模型为 1e-6。设置为 0 可禁用层缩放。
drop_path_rate (`Union[float, int]`,*可选*,默认为 `0.0`):用于 patch 融合的 drop path 比率。
image_size (`Union[int, list[int], tuple[int, int]]`,*可选*,默认为 `224`):每张图片的尺寸(分辨率)。
这是用于存储 ConvNextModel 配置的类。它根据指定的参数实例化 Convnext 模型,并定义模型架构。使用默认值实例化配置将生成与 [facebook/convnext-tiny-224](https://huggingface.co/facebook/convnext-tiny-224) 类似的配置。
配置对象继承自 [PreTrainedConfig](/docs/transformers/main/zh/main_classes/configuration#transformers.PreTrainedConfig),可用于控制模型输出。有关更多信息,请参阅 [PreTrainedConfig](/docs/transformers/main/zh/main_classes/configuration#transformers.PreTrainedConfig) 的文档。
示例:
```python
>>> from transformers import ConvNextConfig, ConvNextModel
>>> # Initializing a ConvNext convnext-tiny-224 style configuration
>>> configuration = ConvNextConfig()
>>> # Initializing a model (with random weights) from the convnext-tiny-224 style configuration
>>> model = ConvNextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ConvNextImageProcessor[[transformers.ConvNextImageProcessor]]
#### transformers.ConvNextImageProcessor[[transformers.ConvNextImageProcessor]]
```python
transformers.ConvNextImageProcessor(**kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/image_processing_convnext.py#L43)
**参数:**
do_convert_rgb (`bool`, *kwargs*, *可选*) : 是否将图像转换为 RGB。
do_resize (`bool`, *kwargs*, *可选*, 默认为 `True`) : 是否调整图像大小。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*,默认为 `{'shortest_edge' : 384}`):描述输入到模型的最大尺寸。
default_to_square (`bool`, *kwargs*, *可选*,默认为 `False`) : 当 size 为整数时,是否在调整大小时默认使用正方形图像。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 应用 `center_crop` 后输出图像的尺寸。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*,默认值为 `3`) : 如果调整图像大小,则使用的重采样滤波器。它可以是枚举 `PILImageResampling` 中的一个值。仅当 `do_resize` 设置为 `True` 时才会生效。
do_rescale (`bool`, *kwargs*, *可选*,默认为 `True`):是否对图像进行重新缩放。
rescale_factor (`float`, *kwargs*, *可选*,默认为 `0.00392156862745098`) : 当 `do_rescale` 设置为 `True` 时,用于对图像进行缩放的缩放因子。
do_normalize (`bool`,*kwargs*,*可选*,默认为 `True`):是否对图像进行归一化。
image_mean (`Union[float, list[float], tuple[float, ...]]`,*kwargs*,*可选*,默认为 `[0.5, 0.5, 0.5]`):用于归一化的图像均值。仅当 `do_normalize` 设置为 `True` 时生效。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *可选*,默认为 `[0.5, 0.5, 0.5]`) : 用于归一化的图像标准差。仅当 `do_normalize` 设置为 `True` 时生效。
do_pad (`bool`, *kwargs*, *可选*) : 是否对图像进行填充。填充操作会将图像填充至批次中的最大尺寸,或填充至每张图像的固定正方形尺寸。具体的填充策略取决于模型。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 用于将图像填充到的尺寸,格式为 `{"height": int, "width" int}`。该尺寸必须大于预处理中提供的任何图像尺寸。如果未提供 `pad_size`,图像将被填充到批次中最大的高度和宽度。仅在 `do_pad=True.` 时应用。
do_center_crop (`bool`, *kwargs*, *可选*) : 是否对图像进行居中裁剪。
data_format (`Union[str, ~image_utils.ChannelDimension]`,*kwargs*,*可选*):仅支持 `ChannelDimension.FIRST`。为兼容旧版处理器而添加。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *可选*) : 输入图像的通道维度格式。如果未设置,则从输入图像中推断通道维度格式。可以是以下之一: - `"channels_first"` 或 `ChannelDimension.FIRST`:图像为 (num_channels, height, width) 格式。 - `"channels_last"` 或 `ChannelDimension.LAST`:图像为 (height, width, num_channels) 格式。 - `"none"` 或 `ChannelDimension.NONE`:图像为 (height, width) 格式。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*):用于处理视频的设备。如果未设置,则从输入视频中推断设备。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : 如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像 token 数量。为向后兼容而添加,但在未来的模型中,应将其设置为处理器的属性。
crop_pct (`float`, *kwargs*, *可选*,默认为 `self.crop_pct`) : 要裁剪的图像比例。仅当 size < 384 时生效。
构建一个 ConvNextImageProcessor 图像处理器。
#### preprocess[[transformers.ConvNextImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**参数:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 要预处理的图像。期望输入单张或一批像素值在 0 到 255 之间的图像。如果传入的图像像素值在 0 到 1 之间,请设置 `do_rescale=False`。
image_like_kwargs (`dict[str, Any]`,*可选*):用于额外图像类输入的开发者标志,这些输入也将被预处理。仅在以关键字参数传递输入不起作用时使用此标志。例如,`preprocess(images, masks=masks)` 是首选方式,但对于某些模型会导致参数优先级问题。在这种情况下,可以改用 `preprocess(images, image_like_inputs={"masks": masks})`。
do_convert_rgb (`bool`, *kwargs*, *可选*) : 是否将图像转换为 RGB。
do_resize (`bool`,*kwargs*,*可选*):是否调整图像大小。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*):描述模型的最大输入维度。
default_to_square (`bool`, *kwargs*, *可选*) : 当 size 为 int 时,是否在调整大小时默认使用正方形图像。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 应用 `center_crop` 后输出图像的尺寸。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 如果调整图像大小,则使用的重采样滤波器。它可以是枚举 `PILImageResampling` 中的一个值。仅当 `do_resize` 设置为 `True` 时才会生效。
do_rescale (`bool`, *kwargs*, *可选*) : 是否对图像进行重新缩放。
rescale_factor (`float`, *kwargs*, *可选*) : 当 `do_rescale` 设置为 `True` 时,用于对图像进行缩放的缩放因子。
do_normalize (`bool`, *kwargs*, *可选*) : 是否对图像进行归一化。
image_mean (`Union[float, list[float], tuple[float, ...]]`,*kwargs*,*可选*):用于归一化的图像均值。仅当 `do_normalize` 设置为 `True` 时生效。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *可选*) : 用于归一化的图像标准差。仅当 `do_normalize` 设置为 `True` 时生效。
do_pad (`bool`, *kwargs*, *可选*) : 是否对图像进行填充。填充操作会将图像填充至批次中的最大尺寸,或填充至每张图像的固定正方形尺寸。具体的填充策略取决于模型。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 用于将图像填充到的尺寸,格式为 `{"height": int, "width" int}`。该尺寸必须大于预处理中提供的任何图像尺寸。如果未提供 `pad_size`,图像将被填充到批次中最大的高度和宽度。仅在 `do_pad=True.` 时应用。
do_center_crop (`bool`, *kwargs*, *可选*) : 是否对图像进行居中裁剪。
data_format (`Union[str, ~image_utils.ChannelDimension]`,*kwargs*,*可选*):仅支持 `ChannelDimension.FIRST`。为兼容旧版处理器而添加。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *可选*) : 输入图像的通道维度格式。如果未设置,则从输入图像中推断通道维度格式。可以是以下之一: - `"channels_first"` 或 `ChannelDimension.FIRST`:图像为 (num_channels, height, width) 格式。 - `"channels_last"` 或 `ChannelDimension.LAST`:图像为 (height, width, num_channels) 格式。 - `"none"` 或 `ChannelDimension.NONE`:图像为 (height, width) 格式。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*):用于处理视频的设备。如果未设置,则从输入视频中推断设备。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : 如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像 token 数量。为向后兼容而添加,但在未来的模型中,应将其设置为处理器的属性。
**返回:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- 由 __call__ 方法返回的列表/数组/张量字典(例如 'pixel_values')。
- **tensor_type** (`Union[None, str, TensorType]`,*可选*) -- 您可以在此处指定 tensor_type,以便在初始化时将 PyTorch/Numpy 张量中的整数列表进行转换。
预处理一张图像或一批图像。
## ConvNextImageProcessorPil[[transformers.ConvNextImageProcessorPil]]
#### transformers.ConvNextImageProcessorPil[[transformers.ConvNextImageProcessorPil]]
```python
transformers.ConvNextImageProcessorPil(**kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/image_processing_pil_convnext.py#L43)
**参数:**
do_convert_rgb (`bool`, *kwargs*, *可选*) : 是否将图像转换为 RGB。
do_resize (`bool`, *kwargs*, *可选*, 默认为 `True`) : 是否调整图像大小。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*,默认为 `{'shortest_edge' : 384}`):描述输入到模型的最大尺寸。
default_to_square (`bool`, *kwargs*, *可选*,默认为 `False`) : 当 size 为整数时,是否在调整大小时默认使用正方形图像。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 应用 `center_crop` 后输出图像的尺寸。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*,默认值为 `3`) : 如果调整图像大小,则使用的重采样滤波器。它可以是枚举 `PILImageResampling` 中的一个值。仅当 `do_resize` 设置为 `True` 时才会生效。
do_rescale (`bool`, *kwargs*, *可选*,默认为 `True`):是否对图像进行重新缩放。
rescale_factor (`float`, *kwargs*, *可选*,默认为 `0.00392156862745098`) : 当 `do_rescale` 设置为 `True` 时,用于对图像进行缩放的缩放因子。
do_normalize (`bool`,*kwargs*,*可选*,默认为 `True`):是否对图像进行归一化。
image_mean (`Union[float, list[float], tuple[float, ...]]`,*kwargs*,*可选*,默认为 `[0.5, 0.5, 0.5]`):用于归一化的图像均值。仅当 `do_normalize` 设置为 `True` 时生效。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *可选*,默认为 `[0.5, 0.5, 0.5]`) : 用于归一化的图像标准差。仅当 `do_normalize` 设置为 `True` 时生效。
do_pad (`bool`, *kwargs*, *可选*) : 是否对图像进行填充。填充操作会将图像填充至批次中的最大尺寸,或填充至每张图像的固定正方形尺寸。具体的填充策略取决于模型。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 用于将图像填充到的尺寸,格式为 `{"height": int, "width" int}`。该尺寸必须大于预处理中提供的任何图像尺寸。如果未提供 `pad_size`,图像将被填充到批次中最大的高度和宽度。仅在 `do_pad=True.` 时应用。
do_center_crop (`bool`, *kwargs*, *可选*) : 是否对图像进行居中裁剪。
data_format (`Union[str, ~image_utils.ChannelDimension]`,*kwargs*,*可选*):仅支持 `ChannelDimension.FIRST`。为兼容旧版处理器而添加。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *可选*) : 输入图像的通道维度格式。如果未设置,则从输入图像中推断通道维度格式。可以是以下之一: - `"channels_first"` 或 `ChannelDimension.FIRST`:图像为 (num_channels, height, width) 格式。 - `"channels_last"` 或 `ChannelDimension.LAST`:图像为 (height, width, num_channels) 格式。 - `"none"` 或 `ChannelDimension.NONE`:图像为 (height, width) 格式。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*):用于处理视频的设备。如果未设置,则从输入视频中推断设备。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : 如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像 token 数量。为向后兼容而添加,但在未来的模型中,应将其设置为处理器的属性。
crop_pct (`float`, *kwargs*, *可选*,默认为 `self.crop_pct`) : 要裁剪的图像比例。仅当 size < 384 时生效。
构建一个 ConvNextImageProcessor 图像处理器。
#### preprocess[[transformers.ConvNextImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**参数:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 要预处理的图像。期望输入单张或一批像素值在 0 到 255 之间的图像。如果传入的图像像素值在 0 到 1 之间,请设置 `do_rescale=False`。
image_like_kwargs (`dict[str, Any]`,*可选*):用于额外图像类输入的开发者标志,这些输入也将被预处理。仅在以关键字参数传递输入不起作用时使用此标志。例如,`preprocess(images, masks=masks)` 是首选方式,但对于某些模型会导致参数优先级问题。在这种情况下,可以改用 `preprocess(images, image_like_inputs={"masks": masks})`。
do_convert_rgb (`bool`, *kwargs*, *可选*) : 是否将图像转换为 RGB。
do_resize (`bool`,*kwargs*,*可选*):是否调整图像大小。
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*):描述模型的最大输入维度。
default_to_square (`bool`, *kwargs*, *可选*) : 当 size 为 int 时,是否在调整大小时默认使用正方形图像。
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 应用 `center_crop` 后输出图像的尺寸。
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 如果调整图像大小,则使用的重采样滤波器。它可以是枚举 `PILImageResampling` 中的一个值。仅当 `do_resize` 设置为 `True` 时才会生效。
do_rescale (`bool`, *kwargs*, *可选*) : 是否对图像进行重新缩放。
rescale_factor (`float`, *kwargs*, *可选*) : 当 `do_rescale` 设置为 `True` 时,用于对图像进行缩放的缩放因子。
do_normalize (`bool`, *kwargs*, *可选*) : 是否对图像进行归一化。
image_mean (`Union[float, list[float], tuple[float, ...]]`,*kwargs*,*可选*):用于归一化的图像均值。仅当 `do_normalize` 设置为 `True` 时生效。
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *可选*) : 用于归一化的图像标准差。仅当 `do_normalize` 设置为 `True` 时生效。
do_pad (`bool`, *kwargs*, *可选*) : 是否对图像进行填充。填充操作会将图像填充至批次中的最大尺寸,或填充至每张图像的固定正方形尺寸。具体的填充策略取决于模型。
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 用于将图像填充到的尺寸,格式为 `{"height": int, "width" int}`。该尺寸必须大于预处理中提供的任何图像尺寸。如果未提供 `pad_size`,图像将被填充到批次中最大的高度和宽度。仅在 `do_pad=True.` 时应用。
do_center_crop (`bool`, *kwargs*, *可选*) : 是否对图像进行居中裁剪。
data_format (`Union[str, ~image_utils.ChannelDimension]`,*kwargs*,*可选*):仅支持 `ChannelDimension.FIRST`。为兼容旧版处理器而添加。
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *可选*) : 输入图像的通道维度格式。如果未设置,则从输入图像中推断通道维度格式。可以是以下之一: - `"channels_first"` 或 `ChannelDimension.FIRST`:图像为 (num_channels, height, width) 格式。 - `"channels_last"` 或 `ChannelDimension.LAST`:图像为 (height, width, num_channels) 格式。 - `"none"` 或 `ChannelDimension.NONE`:图像为 (height, width) 格式。
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*):用于处理视频的设备。如果未设置,则从输入视频中推断设备。
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : 如果设置为 `'pt'`,则返回堆叠的张量,否则返回张量列表。
disable_grouping (`bool`, *kwargs*, *可选*) : 是否禁用按尺寸对图像进行分组,从而逐个处理图像而非批量处理。如果为 None,则当图像位于 CPU 上时设置为 True,否则设置为 False。此选择基于经验观察,详见此处:https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *可选*) : 输入中每张图片所使用的图像 token 数量。为向后兼容而添加,但在未来的模型中,应将其设置为处理器的属性。
**返回:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- 由 __call__ 方法返回的列表/数组/张量字典(例如 'pixel_values')。
- **tensor_type** (`Union[None, str, TensorType]`,*可选*) -- 您可以在此处指定 tensor_type,以便在初始化时将 PyTorch/Numpy 张量中的整数列表进行转换。
预处理一张图像或一批图像。
## ConvNextModel[[transformers.ConvNextModel]]
#### transformers.ConvNextModel[[transformers.ConvNextModel]]
```python
transformers.ConvNextModel(config: ConvNextConfig)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L251)
**参数:**
config ([ConvNextConfig](/docs/transformers/main/zh/model_doc/convnext#transformers.ConvNextConfig)):模型配置类,包含模型的所有参数。使用配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/main/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
未添加任何特定头部的裸 Convnext 模型,直接输出原始隐藏状态。
该模型继承自 [PreTrainedModel](/docs/transformers/main/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.ConvNextModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L265)
**参数:**
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。像素值可通过 [ConvNextImageProcessor](/docs/transformers/main/zh/model_doc/convnext#transformers.ConvNextImageProcessor) 获取。有关详细信息,请参阅 [ConvNextImageProcessor.__call__()](/docs/transformers/main/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)(`processor_class` 使用 [ConvNextImageProcessor](/docs/transformers/main/zh/model_doc/convnext#transformers.ConvNextImageProcessor) 处理图像)。
**返回:** `BaseModelOutputWithPoolingAndNoAttention` 或 `tuple(torch.Tensor)`
`BaseModelOutputWithPoolingAndNoAttention` 或 `torch.Tensor` 元组(如果传入 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([ConvNextConfig](/docs/transformers/main/zh/model_doc/convnext#transformers.ConvNextConfig))和输入。
[ConvNextModel](/docs/transformers/main/zh/model_doc/convnext#transformers.ConvNextModel) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **last_hidden_state**(形状为 `(batch_size, num_channels, height, width)` 的 `torch.Tensor`)-- 模型最后一层输出的隐藏状态序列。
- **pooler_output**(形状为 `(batch_size, hidden_size)` 的 `torch.Tensor`)-- 在空间维度上执行池化操作后的最后一层隐藏状态。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层输出的一个张量,以及每个层输出的一个张量),形状为 `(batch_size, num_channels, height, width)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
示例:
```python
```
## ConvNextForImageClassification[[transformers.ConvNextForImageClassification]]
#### transformers.ConvNextForImageClassification[[transformers.ConvNextForImageClassification]]
```python
transformers.ConvNextForImageClassification(config: ConvNextConfig)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L293)
**参数:**
config ([ConvNextConfig](/docs/transformers/main/zh/model_doc/convnext#transformers.ConvNextConfig)):模型配置类,包含模型的所有参数。使用配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/main/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
带有图像分类头的 ConvNext 模型(在池化特征之上添加一个线性层),例如用于 ImageNet。
该模型继承自 [PreTrainedModel](/docs/transformers/main/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.ConvNextForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/main/src/transformers/models/convnext/modeling_convnext.py#L311)
**参数:**
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。像素值可通过 [ConvNextImageProcessor](/docs/transformers/main/zh/model_doc/convnext#transformers.ConvNextImageProcessor) 获取。有关详细信息,请参阅 [ConvNextImageProcessor.__call__()](/docs/transformers/main/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)(`processor_class` 使用 [ConvNextImageProcessor](/docs/transformers/main/zh/model_doc/convnext#transformers.ConvNextImageProcessor) 处理图像)。
labels (`torch.LongTensor`,形状为 `(batch_size,)`,*可选*) : 用于计算图像分类/回归损失的标签。索引应在 `[0, ..., config.num_labels - 1]` 范围内。如果 `config.num_labels == 1`,则计算回归损失(均方损失);如果 `config.num_labels > 1`,则计算分类损失(交叉熵)。
**返回:** [ImageClassifierOutputWithNoAttention](/docs/transformers/main/zh/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) 或 `tuple(torch.Tensor)`
一个 [ImageClassifierOutputWithNoAttention](/docs/transformers/main/zh/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([ConvNextConfig](/docs/transformers/main/zh/model_doc/convnext#transformers.ConvNextConfig))和输入。
[ConvNextForImageClassification](/docs/transformers/main/zh/model_doc/convnext#transformers.ConvNextForImageClassification) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,当提供 `labels` 时返回) -- 分类损失(如果 config.num_labels==1,则为回归损失)。
- **logits**(形状为 `(batch_size, config.num_labels)` 的 `torch.Tensor`)-- 分类(或当 config.num_labels==1 时为回归)得分(SoftMax 之前)。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层输出的一个张量,以及每个阶段输出的一个张量),形状为 `(batch_size, num_channels, height, width)`。模型在每个阶段输出处的隐藏状态(也称为特征图)。
示例:
```python
>>> from transformers import AutoImageProcessor, ConvNextForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/convnext-tiny-224")
>>> model = ConvNextForImageClassification.from_pretrained("facebook/convnext-tiny-224")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```