# Perceiver
## Обзор
Модель Perceiver IO была предложена в статье [Perceiver IO: A General Architecture for Structured Inputs & Outputs](https://huggingface.co/papers/2107.14795) авторами Andrew Jaegle, Sebastian Borgeaud, Jean-Baptiste Alayrac, Carl Doersch, Catalin Ionescu, David Ding, Skanda Koppula, Daniel Zoran, Andrew Brock, Evan Shelhamer, Olivier Hénaff, Matthew M. Botvinick, Andrew Zisserman, Oriol Vinyals, João Carreira.
Perceiver IO является обобщением [Perceiver](https://huggingface.co/papers/2103.03206) для обработки произвольных выходов в дополнение к произвольным входам. Исходный Perceiver генерировал только одну метку классификации. Помимо меток классификации, Perceiver IO может генерировать, например, язык, оптический поток и мультимодальные видео с аудио. Это достигается с использованием тех же строительных блоков, что и в исходном Perceiver. Вычислительная сложность Perceiver IO линейна относительно размера входа и выхода, а основная часть обработки происходит в латентном пространстве, что позволяет обрабатывать входы и выходы, значительно превышающие по размеру те, с которыми могут справиться стандартные Transformers. Это означает, например, что Perceiver IO может выполнять моделирование языка с маскированием в стиле BERT напрямую с использованием байтов, а не токенизированных входов.
Аннотация из статьи следующая:
*Недавно предложенная модель Perceiver демонстрирует хорошие результаты в нескольких областях (изображения, аудио, мультимодальные данные, облака точек), при этом линейно масштабируясь по вычислительным ресурсам и памяти в зависимости от размера входных данных. Хотя Perceiver поддерживает множество типов входных данных, он способен генерировать только очень простые выходные данные, такие как оценки классов. Perceiver IO преодолевает это ограничение, не жертвуя привлекательными свойствами оригинальной модели, обучаясь гибко запрашивать латентное пространство модели для получения выходных данных произвольного размера и семантики. Perceiver IO по-прежнему разделяет глубину модели и размер данных и по-прежнему линейно масштабируется с размером данных, но теперь в отношении как входных, так и выходных размеров. Полная модель Perceiver IO достигает высоких результатов в задачах с сильно структурированными пространствами выходных данных, таких как естественный язык и визуальное понимание, StarCraft II, а также в многозадачных и мультимодальных областях. В частности, Perceiver IO сопоставим с базовой линией BERT на основе Transformer на языковом бенчмарке GLUE без необходимости токенизации входных данных и достигает наилучших результатов в оценке оптического потока на Sintel.*
Вот краткое описание того, как работает Perceiver:
Основная проблема механизма self-attention в Transformer заключается в том, что требования к времени и памяти масштабируются квадратично с длиной последовательности. В связи с этим модели, такие как BERT и RoBERTa, ограничены максимальной длиной последовательности в 512 токенов. Perceiver решает эту проблему, выполняя self-attention не на входных данных, а на наборе латентных переменных, используя сами входные данные только для cross-attention. Таким образом, требования к времени и памяти больше не зависят от длины входных данных, поскольку используется фиксированное количество латентных переменных, например, 256 или 512. Эти переменные инициализируются случайным образом, после чего обучаются end-to-end с помощью обратного распространения ошибки.
Внутренне [PerceiverModel](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverModel) создаёт латенты, представляющие собой тензор формы `(batch_size, num_latents, d_latents)`. Необходимо предоставить модели `inputs` (это может быть текст, изображения, аудио или что угодно!), которые она использует для выполнения кросс-внимания с латентами. Выходом Perceiver-энкодера является тензор той же формы. Затем, аналогично BERT, можно преобразовать последние скрытые состояния латентов в логиты классификации, усредняя их вдоль размерности последовательности и добавив сверху линейный слой для проекции `d_latents` в `num_labels`.
Именно эта идея легла в основу оригинальной статьи Perceiver. Однако модель могла выдавать только логиты для классификации. В последующей работе PerceiverIO подход был обобщен, чтобы модель могла генерировать выходные данные произвольного размера. Как это делается? Идея на самом деле относительно проста: определяются выходные данные произвольного размера, после чего применяется кросс-внимание с последними скрытыми состояниями латентов, где выходные данные используются в качестве запросов, а латенты — в качестве ключей и значений.
Допустим, нужно выполнить masked language modeling (в стиле BERT) с помощью Perceiver. Поскольку длина входной последовательности Perceiver не влияет на время вычислений в слоях self-attention, можно передавать моделью сырые байты, задавая `inputs` длиной 2048. Если теперь замаскировать часть из этих 2048 токенов, можно определить `outputs` как тензор формы `(batch_size, 2048, 768)`. Далее выполняется cross-attention с финальными скрытыми состояниями латентов для обновления тензора `outputs`. После cross-attention по-прежнему остается тензор формы `(batch_size, 2048, 768)`. Затем наверх можно поставить обычный заголовок для language modeling, чтобы спроецировать последнее измерение в размер словаря модели, то есть создать логиты формы `(batch_size, 2048, 262)` (поскольку Perceiver использует словарь из 262 байтовых идентификаторов).
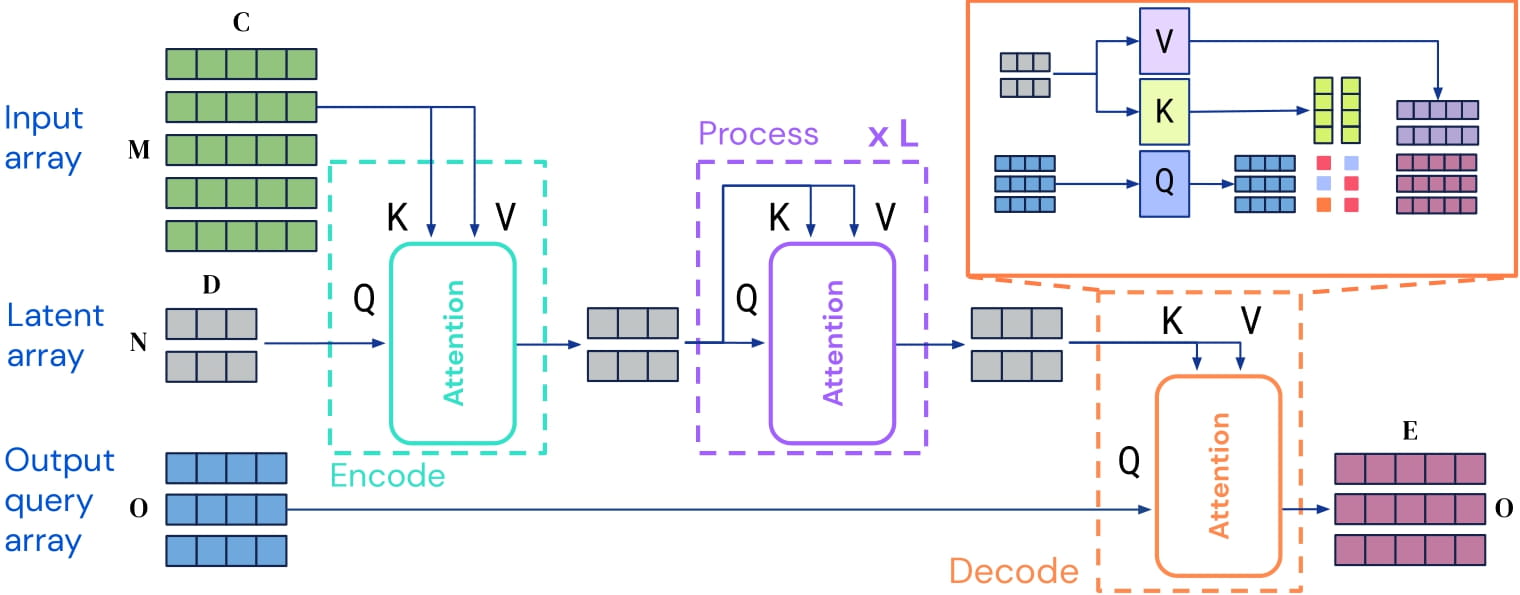 Архитектура Perceiver IO. Взята из оригинальной статьи
Эта модель была предоставлена пользователем [nielsr](https://huggingface.co/nielsr). Исходный код можно найти [здесь](https://github.com/deepmind/deepmind-research/tree/master/perceiver).
Perceiver **не** работает с `torch.nn.DataParallel` из-за ошибки в PyTorch, см. [issue #36035](https://github.com/pytorch/pytorch/issues/36035)
## Ресурсы
- Самый быстрый способ начать работу с Perceiver — это посмотреть [учебные ноутбуки](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Perceiver).
- См. [статью в блоге](https://huggingface.co/blog/perceiver), если вы хотите полностью понять, как работает модель, и
is реализована в библиотеке. Обратите внимание, что модели, доступные в библиотеке, демонстрируют лишь некоторые примеры того, что можно сделать с помощью Perceiver. Существует множество других сценариев использования, включая ответы на вопросы, распознавание именованных сущностей, обнаружение объектов, классификацию аудио, классификацию видео и т. д.
- [Руководство по задаче классификации текста](../tasks/sequence_classification)
- [Руководство по задаче маскированного языкового моделирования](../tasks/masked_language_modeling)
- [Руководство по задаче классификации изображений](../tasks/image_classification)
## Специфические для Perceiver выходные данные[[transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput(logits: typing.Optional[torch.Tensor] = None, last_hidden_state: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L53)
**Параметры:**
logits (`torch.Tensor` формы `(batch_size, num_labels)`) : Оценки классификации (или регрессии, если config.num_labels==1) (до SoftMax).
last_hidden_state (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) : Последовательность скрытых состояний на выходе последнего слоя модели.
hidden_states (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) : Кортеж из `torch.Tensor` (один для вывода эмбеддингов, если у модели есть слой эмбеддингов, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`. Скрытые состояния модели на выходе каждого слоя, а также необязательные начальные выводы эмбеддингов.
attentions (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) : Кортеж `torch.Tensor` (по одному для каждого слоя) формы `(batch_size, num_heads, sequence_length, sequence_length)`. Веса внимания после softmax-функции внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
cross_attentions (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) : Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`. Веса внимания кросс-внимательного слоя декодера после softmax внимания, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Базовый класс для выходов базовой модели Perceiver, с возможными скрытыми состояниями, внимания и кросс-внимания.
#### transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput(logits: typing.Optional[torch.Tensor] = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L72)
**Параметры:**
logits (`torch.Tensor` формы `(batch_size, num_labels)`) : Вывод базового декодера.
cross_attentions (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) : Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`. Веса внимания кросс-внимательного слоя декодера после softmax внимания, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Базовый класс для выходов декодера Perceiver с возможными кросс-вниманиями.
#### transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput(loss: typing.Optional[torch.Tensor] = None, logits: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L88)
**Параметры:**
loss (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) : Потеря маскированного языкового моделирования (MLM).
logits (`torch.Tensor` формы `(batch_size, sequence_length, config.vocab_size)`) : Оценки предсказаний языковой модели (оценки для каждого токена словаря до SoftMax).
hidden_states (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) : Кортеж из `torch.Tensor` (один для вывода эмбеддингов, если у модели есть слой эмбеддингов, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`. Скрытые состояния модели на выходе каждого слоя, а также необязательные начальные выводы эмбеддингов.
attentions (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) : Кортеж `torch.Tensor` (по одному для каждого слоя) формы `(batch_size, num_heads, sequence_length, sequence_length)`. Веса внимания после softmax-функции внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
cross_attentions (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) : Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`. Веса внимания кросс-внимательного слоя декодера после softmax внимания, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Базовый класс для выходов модели Perceiver с маскированием языковых токенов.
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput(loss: typing.Optional[torch.Tensor] = None, logits: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L110)
**Параметры:**
loss (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) : Потери классификации (или регрессии, если config.num_labels==1).
logits (`torch.Tensor` формы `(batch_size, config.num_labels)`) : Оценки классификации (или регрессии, если config.num_labels==1) (до SoftMax).
hidden_states (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) : Кортеж из `torch.Tensor` (один для вывода эмбеддингов, если у модели есть слой эмбеддингов, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`. Скрытые состояния модели на выходе каждого слоя, а также необязательные начальные выводы эмбеддингов.
attentions (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) : Кортеж `torch.Tensor` (по одному для каждого слоя) формы `(batch_size, num_heads, sequence_length, sequence_length)`. Веса внимания после softmax-функции внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
cross_attentions (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) : Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`. Веса внимания кросс-внимательного слоя декодера после softmax внимания, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Базовый класс для выходов моделей Perceiver, предназначенных для классификации последовательностей/изображений, оценки оптического потока и мультимодального автокодирования.
## PerceiverConfig[[transformers.PerceiverConfig]]
#### transformers.PerceiverConfig[[transformers.PerceiverConfig]]
```python
transformers.PerceiverConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_latents: int = 256, d_latents: int = 1280, d_model: int = 768, num_blocks: int = 1, num_self_attends_per_block: int = 26, num_self_attention_heads: int = 8, num_cross_attention_heads: int = 8, qk_channels: int | None = None, v_channels: int | None = None, cross_attention_shape_for_attention: str = 'kv', self_attention_widening_factor: int = 1, cross_attention_widening_factor: int = 1, hidden_act: str = 'gelu', attention_probs_dropout_prob: float | int = 0.1, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, use_query_residual: bool = True, vocab_size: int = 262, max_position_embeddings: int = 2048, image_size: int | list[int] | tuple[int, int] = 56, train_size: list[int] | tuple[int, ...] = (368, 496), num_frames: int = 16, audio_samples_per_frame: int = 1920, samples_per_patch: int = 16, output_shape: list[int] | tuple[int, ...] = (1, 16, 224, 224), output_num_channels: int = 512, _label_trainable_num_channels: int = 1024)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/configuration_perceiver.py#L24)
**Параметры:**
num_latents (`int`, *необязательный*, по умолчанию 256) : Количество латентов.
d_latents (`int`, *optional*, по умолчанию 1280) : Размерность латентных эмбеддингов.
d_model (`int`, *необязательный*, по умолчанию `768`) : Размер слоев кодировщика и пулера.
num_blocks (`int`, *необязательный*, по умолчанию 1) : Количество блоков в кодере Transformer.
num_self_attends_per_block (`int`, *optional*, по умолчанию 26) : Количество слоев само-внимания в каждом блоке.
num_self_attention_heads (`int`, *optional*, по умолчанию 8) : Количество голов внимания для каждого слоя само-внимания в кодере Transformer.
num_cross_attention_heads (`int`, *optional*, по умолчанию 8) : Количество голов внимания для каждого слоя кросс-внимания в кодере Transformer.
qk_channels (`int`, *optional*) : Размерность, к которой проецируются запросы и ключи перед применением внимания в слоях кросс-внимания и само-внимания энкодера. Если не указано, по умолчанию сохраняется размерность запросов.
v_channels (`int`, *optional*) : Размерность, к которой проецируются значения перед применением внимания в слоях кросс-внимания и само-внимания энкодера. Если не указано, по умолчанию сохраняется размерность запросов.
cross_attention_shape_for_attention (`str`, *необязательный*, по умолчанию `"kv"`) : Размерность, используемая при даунсемплинге запросов и ключей в слое кросс-внимания энкодера.
self_attention_widening_factor (`int`, *optional*, по умолчанию 1) : Размерность слоя с прямой передачей в слое кросс-внимания кодировщика Transformer.
cross_attention_widening_factor (`int`, *optional*, по умолчанию 1) : Размерность полносвязного слоя в слоях само-внимания кодировщика Transformer.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
attention_probs_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Доля dropout для вероятностей внимания.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-12`) : Значение epsilon, используемое слоями нормализации.
use_query_residual (`float`, *optional*, по умолчанию `True`) : Добавлять ли остаточное соединение запроса в слое кросс-внимания энкодера.
vocab_size (`int`, *необязательный*, по умолчанию `262`) : Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены в `input_ids`.
max_position_embeddings (`int`, *необязательный*, по умолчанию `2048`) : Максимальная длина последовательности, с которой может использоваться данная модель.
image_size (`int`, *необязательный*, по умолчанию 56) : Размер изображений после предобработки, для [PerceiverForImageClassificationLearned](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned).
train_size (`list[int]`, *необязательный*, по умолчанию `[368, 496]`) : Размер изображений для обучения модели оптического потока.
num_frames (`int`, *optional*, по умолчанию 16) : Количество кадров видео, используемых мультимодальной моделью автокодирования.
audio_samples_per_frame (`int`, *optional*, по умолчанию 1920) : Количество аудиовыборок на кадр для мультимодальной модели автокодирования.
samples_per_patch (`int`, *optional*, по умолчанию 16) : Количество аудиовыборок на патч при предобработке аудио для мультимодальной модели автокодирования.
output_shape (`list[int]`, *необязательный*, по умолчанию `[1, 16, 224, 224]`) : Форма выходных данных (batch_size, num_frames, height, width) для запросов декодера видео мультимодальной модели автокодирования. Это исключает размерность каналов.
output_num_channels (`int`, *optional*, по умолчанию 512) : Количество выходных каналов для каждого декодера модальности.
Это класс конфигурации для хранения настроек модели PerceiverModel. Он используется для создания модели Perceiver в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [deepmind/language-perceiver](https://huggingface.co/deepmind/language-perceiver)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import PerceiverModel, PerceiverConfig
>>> # Initializing a Perceiver deepmind/language-perceiver style configuration
>>> configuration = PerceiverConfig()
>>> # Initializing a model from the deepmind/language-perceiver style configuration
>>> model = PerceiverModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## PerceiverTokenizer[[transformers.PerceiverTokenizer]]
#### transformers.PerceiverTokenizer[[transformers.PerceiverTokenizer]]
```python
transformers.PerceiverTokenizer(pad_token = '[PAD]', bos_token = '[BOS]', eos_token = '[EOS]', mask_token = '[MASK]', cls_token = '[CLS]', sep_token = '[SEP]', model_max_length = 2048, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/tokenization_perceiver.py#L23)
**Параметры:**
pad_token (`str`, *необязательный*, по умолчанию `"[PAD]"`) : Токен, используемый для выравнивания, например, при пакетной обработке последовательностей разной длины.
bos_token (`str`, *необязательный*, по умолчанию `"[BOS]"`) : Токен BOS (зарезервирован в словаре, но фактически не используется).
eos_token (`str`, *optional*, по умолчанию `"[EOS]"`) : Токен конца последовательности (зарезервирован в словаре, но фактически не используется). При построении последовательности с использованием специальных токенов для обозначения конца последовательности не используется этот токен. Используется токен `sep_token`.
mask_token (`str`, *необязательный*, по умолчанию `"[MASK]"`) : Токен MASK, полезный для моделирования языка с маскированием.
cls_token (`str`, *необязательный*, по умолчанию `"[CLS]"`) : Токен CLS (зарезервирован в словаре, но фактически не используется).
sep_token (`str`, *необязательный*, по умолчанию `"[SEP]"`) : Токен-разделитель, используемый при построении последовательности из двух последовательностей.
Создайте токенизатор Perceiver. Perceiver просто использует кодировку utf-8 для сырых байтов.
Этот токенизатор наследуется от [PreTrainedTokenizer](/docs/transformers/main/ru/main_classes/tokenizer#transformers.PythonBackend), который содержит большинство основных методов. Для получения дополнительной информации об этих методах пользователям следует обратиться к этому суперклассу.
#### __call__[[transformers.PerceiverTokenizer.__call__]]
```python
__call__(text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, add_special_tokens: bool = True, padding: bool | str | PaddingStrategy = False, truncation: bool | str | TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, is_split_into_words: bool = False, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, tokenizer_kwargs: dict[str, Any] | None = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/tokenization_utils_base.py#L2449)
**Параметры:**
text (`str`, `list[str]`, `list[list[str]]`, *необязательный*) : Последовательность или батч последовательностей для кодирования. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если последовательности заданы в виде списка строк (предтокенизированных), необходимо установить `is_split_into_words=True` (чтобы устранить неоднозначность с батчем последовательностей).
text_pair (`str`, `list[str]`, `list[list[str]]`, *необязательный*) : Последовательность или батч последовательностей для кодирования. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если последовательности заданы в виде списка строк (предтокенизированных), необходимо установить `is_split_into_words=True` (чтобы устранить неоднозначность с батчем последовательностей).
text_target (`str`, `list[str]`, `list[list[str]]`, *необязательный*) : Последовательность или батч последовательностей, которые нужно закодировать в качестве целевых текстов. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если последовательности заданы в виде списка строк (предтокенизированных), необходимо установить `is_split_into_words=True` (чтобы устранить неоднозначность с батчем последовательностей).
text_pair_target (`str`, `list[str]`, `list[list[str]]`, *необязательный*) : Последовательность или батч последовательностей, которые нужно закодировать в качестве целевых текстов. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если последовательности заданы в виде списка строк (предтокенизированных), необходимо установить `is_split_into_words=True` (чтобы устранить неоднозначность с батчем последовательностей).
tokenizer_kwargs (`dict[str, Any]`, *необязательный*) : Дополнительные kwargs для передачи в токенизатор. Они будут объединены с явными параметрами и другими kwargs, при этом явные параметры имеют приоритет.
add_special_tokens (`bool`, *необязательный*, по умолчанию `True`) : Указывает, следует ли добавлять специальные токены при кодировании последовательностей. Для этого используется базовая функция `PretrainedTokenizerBase.build_inputs_with_special_tokens`, которая определяет, какие токены автоматически добавляются к входным идентификаторам. Это полезно, если вы хотите автоматически добавлять токены `bos` или `eos`.
padding (`bool`, `str` или [PaddingStrategy](/docs/transformers/main/ru/internal/file_utils#transformers.utils.PaddingStrategy), *необязательный*, по умолчанию `False`) : Включает и управляет выравниванием. Принимает следующие значения: - `True` или `'longest'`: Выравнивание до самой длинной последовательности в батче (или без выравнивания, если предоставлена только одна последовательность). - `'max_length'`: Выравнивание до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. - `False` или `'do_not_pad'` (по умолчанию): Без выравнивания (т. е. на выходе может быть батч с последовательностями разной длины).
truncation (`bool`, `str` или [TruncationStrategy](/docs/transformers/main/ru/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *необязательный*, по умолчанию `False`) : Включает и управляет усечением. Принимает следующие значения: - `True` или `'longest_first'`: Усечение до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Усечение выполняется посимвольно: если предоставлена пара последовательностей (или пакет пар), то символ удаляется из самой длинной последовательности в паре. - `'only_first'`: Усечение до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Если предоставлена пара последовательностей (или пакет пар), усечение выполняется только для первой последовательности в паре. - `'only_second'`: Усечение до максимальной длины, указанной в аргументе `max_length`, или до максимально допустимой входной длины для модели, если этот аргумент не указан. Если предоставлена пара последовательностей (или пакет пар), усечение выполняется только для второй последовательности в паре. - `False` или `'do_not_truncate'` (по умолчанию): Усечение не выполняется (т. е. на выходе может быть пакет с длинами последовательностей, превышающими максимально допустимый размер входных данных модели).
max_length (`int`, *optional*) : Управляет максимальной длиной, используемой одним из параметров усечения/дополнения. Если значение не задано или равно `None`, будет использована предопределённая максимальная длина модели, если один из параметров усечения/дополнения требует указания максимальной длины. Если у модели нет конкретной максимальной длины входных данных (как у XLNet), усечение/дополнение до максимальной длины будет отключено.
stride (`int`, *optional*, по умолчанию 0) : Если задано число вместе с `max_length`, то переполненные токены, возвращаемые при `return_overflowing_tokens=True`, будут содержать некоторые токены из конца усечённой последовательности, чтобы обеспечить перекрытие между усечённой и переполненной последовательностями. Значение этого аргумента определяет количество перекрывающихся токенов.
is_split_into_words (`bool`, *необязательный*, по умолчанию `False`) : Указывает, является ли вход уже предтокенизированным (например, разбитым на слова). Если установлено в `True`, токенизатор предполагает, что вход уже разбит на слова (например, по пробелам), и токенизирует их. Это полезно для NER или классификации токенов.
pad_to_multiple_of (`int`, *optional*) : Если задано, последовательность будет дополнена до кратного указанного значения. Требуется, чтобы `padding` был активирован. Это особенно полезно для использования Tensor Cores на аппаратных средствах NVIDIA с вычислительной способностью `>= 7.5` (Volta).
padding_side (`str`, *необязательный*) : Сторона, на которой модель должна применять выравнивание. Значение выбирается из ['right', 'left']. Значение по умолчанию берётся из атрибута класса с тем же именем.
return_tensors (`str` или [TensorType](/docs/transformers/main/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры вместо списка целых чисел Python. Допустимые значения: - `'pt'`: Возвращает объекты `torch.Tensor` PyTorch. - `'np'`: Возвращает объекты `np.ndarray` Numpy.
return_token_type_ids (`bool`, *необязательный*) : Указывает, следует ли возвращать идентификаторы типов токенов. Если значение не задано, идентификаторы типов токенов будут возвращены в соответствии со значением по умолчанию конкретного токенизатора, определяемым атрибутом `return_outputs`. [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
return_attention_mask (`bool`, *необязательный*) : Указывает, следует ли возвращать маску внимания. Если значение не задано, маска внимания будет возвращена в соответствии со значением по умолчанию конкретного токенизатора, определяемым атрибутом `return_outputs`. [Что такое маски внимания?](../glossary#attention-mask)
return_overflowing_tokens (`bool`, *необязательный*, по умолчанию `False`) : Возвращать ли переполненные последовательности токенов. Если передана пара последовательностей входных идентификаторов (или батч пар) с `truncation_strategy = longest_first` или `True`, вместо возврата переполненных токенов будет выброшена ошибка.
return_special_tokens_mask (`bool`, *необязательный*, по умолчанию `False`) : Нужно ли возвращать информацию о маске специальных токенов.
return_offsets_mapping (`bool`, *необязательный*, по умолчанию `False`) : Возвращать или нет `(char_start, char_end)` для каждого токена. Это доступно только для быстрых токенизаторов, наследующихся от [PreTrainedTokenizerFast](/docs/transformers/main/ru/main_classes/tokenizer#transformers.TokenizersBackend); при использовании токенизатора на Python этот метод вызовет `NotImplementedError`.
return_length (`bool`, *необязательный*, по умолчанию `False`) : Возвращать ли длины закодированных входных данных.
verbose (`bool`, *необязательный*, по умолчанию `True`) : Выводить ли дополнительную информацию и предупреждения.
- ****kwargs** : передаются в метод `self.tokenize()`
**Возвращает:** [BatchEncoding](/docs/transformers/main/ru/main_classes/tokenizer#transformers.BatchEncoding)
[BatchEncoding](/docs/transformers/main/ru/main_classes/tokenizer#transformers.BatchEncoding) со следующими полями:
- **input_ids** -- Список идентификаторов токенов, которые подаются в модель.
[Что такое входные идентификаторы?](../glossary#input-ids)
- **token_type_ids** -- Список идентификаторов типов токенов, передаваемых в модель (если `return_token_type_ids=True` или если *"token_type_ids"* входит в `self.model_input_names`).
[Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
- **attention_mask** -- список индексов, указывающих, на какие токены модель должна обращать внимание (когда `return_attention_mask=True` или если *"attention_mask"* входит в `self.model_input_names`).
[Что такое маски внимания?](../glossary#attention-mask)
- **overflowing_tokens** -- Список переполненных последовательностей токенов (если заданы `max_length` и `return_overflowing_tokens=True`).
- **num_truncated_tokens** -- Количество отсечённых токенов (если задано `max_length` и `return_overflowing_tokens=True`).
- **special_tokens_mask** -- Список нулей и единиц, где 1 указывает на добавленные специальные токены, а 0 — на обычные токены последовательности (при `add_special_tokens=True` и `return_special_tokens_mask=True`).
- **length** -- Длина входных данных (когда `return_length=True`)
Основной метод для токенизации и подготовки одной или нескольких последовательностей или одной или нескольких пар последовательностей для модели.
## PerceiverImageProcessor[[transformers.PerceiverImageProcessor]]
#### transformers.PerceiverImageProcessor[[transformers.PerceiverImageProcessor]]
```python
transformers.PerceiverImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/image_processing_perceiver.py#L33)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 224, 'width': 224}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 256, 'width': 256}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.485, 0.456, 0.406]`) : Средние значения изображения, используемые для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.229, 0.224, 0.225]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Создаёт процессор изображений PerceiverImageProcessor.
#### preprocess[[transformers.PerceiverImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *необязательный*) : Флаг разработчика для дополнительных изображений и похожих на них входных данных, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например, `preprocess(images, masks=masks)` — предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использовать `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
## PerceiverImageProcessorPil[[transformers.PerceiverImageProcessorPil]]
#### transformers.PerceiverImageProcessorPil[[transformers.PerceiverImageProcessorPil]]
```python
transformers.PerceiverImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/image_processing_pil_perceiver.py#L31)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 224, 'width': 224}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 256, 'width': 256}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.485, 0.456, 0.406]`) : Средние значения изображения, используемые для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.229, 0.224, 0.225]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Создаёт процессор изображений PerceiverImageProcessor.
#### preprocess[[transformers.PerceiverImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *необязательный*) : Флаг разработчика для дополнительных изображений и похожих на них входных данных, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например, `preprocess(images, masks=masks)` — предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использовать `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
## PerceiverTextPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor(config: PerceiverConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2662)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Конфигурация модели.
Предобработка текста для Perceiver Encoder. Может использоваться для встраивания `inputs` и добавления позиционных кодировок.
Размерность эмбеддингов определяется атрибутом `d_model` конфигурации.
## PerceiverImagePreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor(config, prep_type = 'conv', spatial_downsample: int = 4, temporal_downsample: int = 1, position_encoding_type: str = 'fourier', in_channels: int = 3, out_channels: int = 64, conv_after_patching: bool = False, conv_after_patching_in_channels: int = 54, conv2d_use_batchnorm: bool = True, concat_or_add_pos: str = 'concat', project_pos_dim: int = -1, **position_encoding_kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2825)
**Параметры:**
config ([*PerceiverConfig*]) : Конфигурация модели.
prep_type (`str`, *необязательный*, по умолчанию `"conv"`) : Тип предобработки. Может принимать значения "conv1x1", "conv", "patches", "pixels".
spatial_downsample (`int`, *optional*, по умолчанию 4) : Коэффициент пространственного уменьшения.
temporal_downsample (`int`, *optional*, по умолчанию 1) : Коэффициент временного даунсемплинга (актуально только при наличии временного измерения).
position_encoding_type (`str`, *необязательный*, по умолчанию `"fourier"`) : Тип позиционного кодирования. Может быть "fourier" или "trainable".
in_channels (`int`, *необязательный*, по умолчанию 3) : Количество каналов на входе.
out_channels (`int`, *необязательный*, по умолчанию 64) : Количество каналов на выходе.
conv_after_patching (`bool`, *необязательный*, по умолчанию `False`) : Нужно ли применять свёрточный слой после патчинга.
conv_after_patching_in_channels (`int`, *optional*, по умолчанию 54) : Количество каналов на входе свёрточного слоя после патчинга.
conv2d_use_batchnorm (`bool`, *необязательный*, по умолчанию `True`) : Использовать ли пакетную нормализацию в свёрточном слое.
concat_or_add_pos (`str`, *необязательный*, по умолчанию `"concat"`) : Способ конкатенации позиционного кодирования с входом. Может быть "concat" или "add".
project_pos_dim (`int`, *optional*, по умолчанию -1) : Размерность позиционного кодирования, к которой выполняется проекция. Если значение равно -1, проекция не применяется.
- ****position_encoding_kwargs** (`Dict`, *необязательный*) : Именованные аргументы для позиционного кодирования.
Предобработка изображений для Perceiver Encoder.
Примечание: аргумент *out_channels* относится к выходным каналам свёрточного слоя, если *prep_type* установлен в значение "conv1x1" или "conv". Если добавляются абсолютные позиционные эмбеддинги, необходимо убедиться, что *num_channels* в аргументах позиционного кодирования установлено равным *out_channels*.
## PerceiverOneHotPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor(config: PerceiverConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L3063)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Конфигурация модели.
Одногорячий препроцессор для Perceiver Encoder. Может использоваться для добавления фиктивного измерения индекса к входным данным.
## PerceiverAudioPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor(config, prep_type: str = 'patches', samples_per_patch: int = 96, position_encoding_type: str = 'fourier', concat_or_add_pos: str = 'concat', out_channels = 64, project_pos_dim = -1, **position_encoding_kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L3089)
**Параметры:**
config ([*PerceiverConfig*]) : Конфигурация модели.
prep_type (`str`, *необязательный*, по умолчанию `"patches"`) : Тип преобразователя для использования. Поддерживается только "patches".
samples_per_patch (`int`, *optional*, по умолчанию 96) : Количество образцов на патч.
position_encoding_type (`str`, *необязательный*, по умолчанию `"fourier"`) : Тип используемого позиционного кодирования. Может быть "trainable" или "fourier".
concat_or_add_pos (`str`, *необязательный*, по умолчанию `"concat"`) : Способ конкатенации позиционного кодирования с входом. Может быть "concat" или "add".
out_channels (`int`, *необязательный*, по умолчанию 64) : Количество каналов на выходе.
project_pos_dim (`int`, *optional*, по умолчанию -1) : Размерность позиционного кодирования, к которой выполняется проекция. Если значение равно -1, проекция не применяется.
- ****position_encoding_kwargs** (`Dict`, *необязательный*) : Именованные аргументы для позиционного кодирования.
Предобработка аудио для Perceiver Encoder.
## PerceiverMultimodalPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor(modalities: Mapping, mask_probs: collections.abc.Mapping[str, float] | None = None, min_padding_size: int = 2)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L3192)
**Параметры:**
modalities (`Mapping[str, PreprocessorType]`) : Словарь, сопоставляющий имя модальности с преобразователем.
mask_probs (`dict[str, float]`) : Словарь, сопоставляющий имя модальности с вероятностью маскирования этой модальности.
min_padding_size (`int`, *optional*, по умолчанию 2) : минимальный размер отступов для всех модальностей. В конечном выводе num_channels будет равно максимальному числу каналов среди всех модальностей плюс min_padding_size.
Мультимодальная предобработка для Perceiver Encoder.
Входные данные для каждой модальности предварительно обрабатываются, а затем дополняются обучаемыми позиционными эмбеддингами до одинакового количества каналов.
## PerceiverProjectionDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder(config)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1839)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Конфигурация модели.
Базовый проекционный декодер (без кросс-внимания).
## PerceiverBasicDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder(config: PerceiverConfig, output_num_channels: int, position_encoding_type: str | None = 'trainable', output_index_dims: int | None = None, num_channels: int | None = 128, subsampled_index_dims: int | None = None, qk_channels: int | None = None, v_channels: int | None = None, num_heads: int | None = 1, widening_factor: int | None = 1, use_query_residual: bool | None = False, concat_preprocessed_input: bool | None = False, final_project: bool | None = True, position_encoding_only: bool | None = False, **position_encoding_kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1863)
**Параметры:**
config ([*PerceiverConfig*]) : Конфигурация модели.
output_num_channels (`int`, *необязательный*) : Количество каналов на выходе. Используется только в том случае, если *final_project* установлен в `True`.
position_encoding_type (`str`, *необязательный*, по умолчанию "trainable") : Тип позиционного кодирования, который следует использовать. Может быть "trainable", "fourier" или "none".
output_index_dims (`int`, *optional*) : Количество измерений выходных запросов. Игнорируется, если 'position_encoding_type' == 'none'.
num_channels (`int`, *optional*, по умолчанию 128) : Количество каналов запросов декодера. Игнорируется, если 'position_encoding_type' == 'none'.
qk_channels (`int`, *optional*) : Количество каналов запросов и ключей в слое кросс-внимания.
v_channels (`int`, *необязательный*) : Количество каналов значений в слое кросс-внимания.
num_heads (`int`, *optional*, по умолчанию 1) : Количество голов внимания в слое кросс-внимания.
widening_factor (`int`, *optional*, по умолчанию 1) : Коэффициент расширения слоя кросс-внимания.
use_query_residual (`bool`, *необязательный*, по умолчанию `False`) : Использовать ли остаточное соединение между запросом и выходом слоя кросс-внимания.
concat_preprocessed_input (`bool`, *необязательный*, по умолчанию `False`) : Служит для определения, следует ли конкатенировать предобработанный вход с запросом.
final_project (`bool`, *необязательный*, по умолчанию `True`) : Нужно ли проецировать выход слоя кросс-внимания в целевое измерение.
position_encoding_only (`bool`, *необязательный*, по умолчанию `False`) : Использовать ли этот класс только для определения выходных запросов.
Декодер на основе кросс-внимания. Этот класс можно использовать для декодирования финальных скрытых состояний латентов с помощью операции кросс-внимания, в которой латенты формируют ключи и значения.
Форма выходных данных этого класса зависит от того, как определены выходные запросы (также называемые декодерными запросами).
## PerceiverClassificationDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder(config, **decoder_kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2048)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Конфигурация модели.
Декодер классификации на основе кросс-внимания. Лёгкая обёртка над `PerceiverBasicDecoder` для вывода логитов. Преобразует выход Perceiver-энкодера, имеющий форму (batch_size, num_latents, d_latents), в тензор формы (batch_size, num_labels). Запросы имеют форму (batch_size, 1, num_labels).
## PerceiverOpticalFlowDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder(config, output_image_shape, output_num_channels = 2, rescale_factor = 100.0, **decoder_kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2094)
Декодер оптического потока на основе кросс-внимания.
## PerceiverBasicVideoAutoencodingDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder(config: PerceiverConfig, output_shape: list, position_encoding_type: str, **decoder_kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2129)
**Параметры:**
config ([*PerceiverConfig*]) : Конфигурация модели.
output_shape (`list[int]`) : Форма выходных данных в виде (batch_size, num_frames, height, width), без измерения канала.
position_encoding_type (`str`) : Тип используемого позиционного кодирования. Может принимать значения "trainable", "fourier" или "none".
Декодер видео-автокодирования на основе кросс-внимания. Лёгкая обёртка для [*PerceiverBasicDecoder*] с логикой изменения формы видео.
## PerceiverMultimodalDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder(config: PerceiverConfig, modalities: dict, num_outputs: int, output_num_channels: int, min_padding_size: int | None = 2, subsampled_index_dims: dict[str, transformers.models.perceiver.modeling_perceiver.PerceiverAbstractDecoder] | None = None, **decoder_kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2206)
**Параметры:**
config ([*PerceiverConfig*]) : Конфигурация модели.
modalities (`dict[str, PerceiverAbstractDecoder]`) : Словарь, сопоставляющий имя модальности с декодером этой модальности.
num_outputs (`int`) : Количество выходов декодера.
output_num_channels (`int`) : Количество каналов на выходе.
min_padding_size (`int`, *optional*, по умолчанию 2) : минимальный размер отступов для всех модальностей. В конечном выводе num_channels будет равно максимальному числу каналов среди всех модальностей плюс min_padding_size.
subsampled_index_dims (`dict[str, PerceiverAbstractDecoder]`, *необязательный*) : Словарь, сопоставляющий имя модальности с размерностями подвыбранных индексов, используемыми для запроса декодера этой модальности.
Мультимодальное декодирование за счёт композиции уни-модальных декодеров. Аргумент *modalities* конструктора представляет собой словарь, сопоставляющий имя модальности с её декодером. Этот декодер используется для построения запросов для данной модальности. Специфичные для модальности запросы дополняются обучаемыми параметрами, специфичными для модальности, после чего они конкатенируются вдоль временного измерения.
Далее выполняется общая операция кросс-внимания для всех модальностей.
## PerceiverProjectionPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor(in_channels: int, out_channels: int)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2804)
**Параметры:**
in_channels (`int`) : Количество каналов на входе.
out_channels (`int`) : Количество каналов на выходе.
Постобработка проекции для Perceiver. Может использоваться для проекции каналов вывода декодера в пространство меньшей размерности.
## PerceiverAudioPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor(config: PerceiverConfig, in_channels: int, postproc_type: str = 'patches')
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2777)
**Параметры:**
config ([*PerceiverConfig*]) : Конфигурация модели.
in_channels (`int`) : Количество каналов на входе.
postproc_type (`str`, *необязательный*, по умолчанию `"patches"`) : Тип постпроцессора для использования. В настоящее время поддерживается только "patches".
Постобработка аудио для Perceiver. Может использоваться для преобразования вывода декодера в аудио-фичи.
## PerceiverClassificationPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor(config: PerceiverConfig, in_channels: int)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2757)
**Параметры:**
config ([*PerceiverConfig*]) : Конфигурация модели.
in_channels (`int`) : Количество каналов на входе.
Постобработка классификации для Perceiver. Может использоваться для преобразования вывода декодера в логиты классификации.
## PerceiverMultimodalPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor(modalities: Mapping, input_is_dict: bool = False)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2723)
**Параметры:**
modalities (`Mapping[str, PostprocessorType]`) : Словарь, сопоставляющий имя модальности с классом постпроцессора для этой модальности.
input_is_dict (`bool`, *необязательный*, по умолчанию `False`) : Если True, входные данные считаются структурированными в виде словаря, а выходные сохраняют ту же структуру словаря. Если False, входные данные представляют собой тензор, который на этапе постобработки разбивается на части с помощью *modality_sizes*.
Мультимодальная постобработка для Perceiver. Может использоваться для объединения модальностно-специфичных постобработчиков в единый постобработчик.
## PerceiverModel[[transformers.PerceiverModel]]
#### transformers.PerceiverModel[[transformers.PerceiverModel]]
```python
transformers.PerceiverModel(config: PerceiverConfig, decoder: typing.Optional[ForwardRef('PerceiverAbstractDecoder')] = None, input_preprocessor: Callable = None, output_postprocessor: Callable = None)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L561)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
decoder (`PerceiverDecoder`, *необязательный*) : Модуль декодера, который преобразует латентные представления в предсказания для задачи.
input_preprocessor (`PreprocessorType`, *необязательный*) : Preprocessor, кодирующий исходные входные данные в тензоры для модели.
output_postprocessor (`PostprocessorType`, *необязательный*) : Постпроцессор, который преобразует выходные данные модели в окончательные предсказания.
Perceiver: масштабируемая архитектура, полностью основанная на механизме внимания.
Обратите внимание, что Perceiver можно дообучать на изображениях с более высоким разрешением, чем те, на которых он обучался, установив `interpolate_pos_encoding` в `True` в forward модели. Это позволит интерполировать предобученные позиционные эмбеддинги до более высокого разрешения.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.PerceiverModel.forward]]
```python
forward(inputs: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, subsampled_output_points: dict[str, torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, interpolate_pos_encoding: bool = False, return_dict: bool | None = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L597)
**Параметры:**
inputs (`torch.Tensor`) : Входы для перцептора. Может быть чем угодно: изображения, текст, аудио, видео и т. д.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
subsampled_output_points (`dict[str, torch.Tensor]`, *необязательный*) : Словарь тензоров, используемых в качестве запросов для декодера. Декодер отображает эти запросы на латентное представление модели. Используется для декодирования с подвыборкой, например, когда декодируются только определённые участки изображения.
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/main/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
**Возвращает:** [PerceiverModelOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput) или `tuple(torch.Tensor)`
Объект [PerceiverModelOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) и входных данных.
Метод forward модели [PerceiverModel](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **logits** (`torch.Tensor` формы `(batch_size, num_labels)`) -- Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **cross_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания кросс-внимания декодера, после применения softmax к вниманию, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Примеры:
```python
>>> from transformers import PerceiverConfig, PerceiverTokenizer, PerceiverImageProcessor, PerceiverModel
>>> from transformers.models.perceiver.modeling_perceiver import (
... PerceiverTextPreprocessor,
... PerceiverImagePreprocessor,
... PerceiverClassificationDecoder,
... )
>>> import torch
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> # EXAMPLE 1: using the Perceiver to classify texts
>>> # - we define a TextPreprocessor, which can be used to embed tokens
>>> # - we define a ClassificationDecoder, which can be used to decode the
>>> # final hidden states of the latents to classification logits
>>> # using trainable position embeddings
>>> config = PerceiverConfig()
>>> preprocessor = PerceiverTextPreprocessor(config)
>>> decoder = PerceiverClassificationDecoder(
... config,
... num_channels=config.d_latents,
... trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
... use_query_residual=True,
... )
>>> model = PerceiverModel(config, input_preprocessor=preprocessor, decoder=decoder)
>>> # you can then do a forward pass as follows:
>>> tokenizer = PerceiverTokenizer()
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> with torch.no_grad():
... outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()
>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
>>> # EXAMPLE 2: using the Perceiver to classify images
>>> # - we define an ImagePreprocessor, which can be used to embed images
>>> config = PerceiverConfig(image_size=224)
>>> preprocessor = PerceiverImagePreprocessor(
... config,
... prep_type="conv1x1",
... spatial_downsample=1,
... out_channels=256,
... position_encoding_type="trainable",
... concat_or_add_pos="concat",
... project_pos_dim=256,
... trainable_position_encoding_kwargs=dict(
... num_channels=256,
... index_dims=config.image_size**2,
... ),
... )
>>> model = PerceiverModel(
... config,
... input_preprocessor=preprocessor,
... decoder=PerceiverClassificationDecoder(
... config,
... num_channels=config.d_latents,
... trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
... use_query_residual=True,
... ),
... )
>>> # you can then do a forward pass as follows:
>>> image_processor = PerceiverImageProcessor()
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(image, return_tensors="pt").pixel_values
>>> with torch.no_grad():
... outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()
>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
```
## PerceiverForMaskedLM[[transformers.PerceiverForMaskedLM]]
#### transformers.PerceiverForMaskedLM[[transformers.PerceiverForMaskedLM]]
```python
transformers.PerceiverForMaskedLM(config: PerceiverConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L807)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Пример использования Perceiver для моделирования языка с маскированием.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.PerceiverForMaskedLM.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, input_ids: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L839)
**Параметры:**
inputs (`torch.Tensor`, *необязательный*) : Входы для перцептора. Могут быть любыми: изображения, текст, аудио, видео и т. д.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
labels (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Метки для вычисления потерь маскированного языкового моделирования. Индексы должны находиться в диапазоне `[-100, 0, ..., config.vocab_size]` (см. docstring `input_ids`). Токены с индексами, установленными в `-100`, игнорируются (маскируются); потери вычисляются только для токенов с метками в диапазоне `[0, ..., config.vocab_size]`.
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/main/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
input_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/main/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/main/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/main/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
**Возвращает:** [PerceiverMaskedLMOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput) или `tuple(torch.Tensor)`
Объект [PerceiverMaskedLMOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) и входных данных.
Метод forward класса [PerceiverForMaskedLM](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForMaskedLM) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери маскированного языкового моделирования (MLM).
- **logits** (`torch.Tensor` формы `(batch_size, sequence_length, config.vocab_size)`) — Оценки предсказаний языковой модели (оценки для каждого токена словаря до применения SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **cross_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания кросс-внимания декодера, после применения softmax к вниманию, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Примеры:
```python
>>> from transformers import AutoTokenizer, PerceiverForMaskedLM
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForMaskedLM.from_pretrained("deepmind/language-perceiver")
>>> # training
>>> text = "This is an incomplete sentence where some words are missing."
>>> inputs = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask " missing."
>>> inputs["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> labels = tokenizer(text, padding="max_length", return_tensors="pt").input_ids
>>> outputs = model(**inputs, labels=labels)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
19.87
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]
>>> # inference
>>> text = "This is an incomplete sentence where some words are missing."
>>> encoding = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask bytes corresponding to " missing.". Note that the model performs much better if the masked span starts with a space.
>>> encoding["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]
>>> masked_tokens_predictions = logits[0, 52:61].argmax(dim=-1).tolist()
>>> tokenizer.decode(masked_tokens_predictions)
' missing.'
```
## PerceiverForSequenceClassification[[transformers.PerceiverForSequenceClassification]]
#### transformers.PerceiverForSequenceClassification[[transformers.PerceiverForSequenceClassification]]
```python
transformers.PerceiverForSequenceClassification(config: PerceiverConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L940)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Пример использования Perceiver для классификации текста.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.PerceiverForSequenceClassification.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, input_ids: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L961)
**Параметры:**
inputs (`torch.Tensor`, *необязательный*) : Входы для перцептора. Могут быть любыми: изображения, текст, аудио, видео и т. д.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления функции потерь классификации/регрессии. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels == 1`, вычисляется функция потерь регрессии (среднеквадратичная ошибка), если `config.num_labels > 1` — функция потерь классификации (кросс-энтропия).
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/main/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
input_ids (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/main/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/main/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/main/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
**Возвращает:** [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или `tuple(torch.Tensor)`
Объект [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) и входных данных.
Метод forward класса [PerceiverForSequenceClassification](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForSequenceClassification) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **cross_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания кросс-внимания декодера, после применения softmax к вниманию, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Примеры:
```python
>>> from transformers import AutoTokenizer, PerceiverForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForSequenceClassification.from_pretrained("deepmind/language-perceiver")
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
```
## PerceiverForImageClassificationLearned[[transformers.PerceiverForImageClassificationLearned]]
#### transformers.PerceiverForImageClassificationLearned[[transformers.PerceiverForImageClassificationLearned]]
```python
transformers.PerceiverForImageClassificationLearned(config: PerceiverConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1062)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Пример использования Perceiver для классификации изображений, например, для задач типа ImageNet.
Эта модель использует обучаемые позиционные эмбеддинги. Иными словами, модели не предоставляется никакой привилегированной информации о структуре изображений. Как показано в статье, эта модель способна достичь точности top-1 на уровне 72.7 на ImageNet.
[PerceiverForImageClassificationLearned](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) использует [PerceiverImagePreprocessor](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (с `prep_type="conv1x1"`) для предобработки входных изображений, а [PerceiverClassificationDecoder](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) — для декодирования латентного представления [PerceiverModel](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverModel) в логиты классификации.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.PerceiverForImageClassificationLearned.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1093)
**Параметры:**
inputs (`torch.Tensor`, *необязательный*) : Входы для перцептора. Могут быть любыми: изображения, текст, аудио, видео и т. д.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления потерь классификации/регрессии изображений. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels == 1`, вычисляется потеря регрессии (среднеквадратичная потеря), если `config.num_labels > 1`, вычисляется потеря классификации (кросс-энтропия).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/main/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [PerceiverImageProcessor](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverImageProcessor). Подробности см. в [PerceiverImageProcessor.__call__()](/docs/transformers/main/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [PerceiverImageProcessor](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverImageProcessor) для обработки изображений).
**Возвращает:** [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или `tuple(torch.Tensor)`
Объект [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) и входных данных.
Метод forward класса [PerceiverForImageClassificationLearned](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **cross_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания кросс-внимания декодера, после применения softmax к вниманию, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Примеры:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationLearned
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-learned")
>>> model = PerceiverForImageClassificationLearned.from_pretrained("deepmind/vision-perceiver-learned")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForImageClassificationFourier[[transformers.PerceiverForImageClassificationFourier]]
#### transformers.PerceiverForImageClassificationFourier[[transformers.PerceiverForImageClassificationFourier]]
```python
transformers.PerceiverForImageClassificationFourier(config: PerceiverConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1187)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Пример использования Perceiver для классификации изображений, например, для задач типа ImageNet.
Эта модель использует фиксированные 2D-Фурье-вложения позиций. Как показано в статье, эта модель может достичь точности top-1 79.0 на ImageNet и 84.5 при предварительном обучении на крупномасштабном наборе данных (например, JFT).
[PerceiverForImageClassificationLearned](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) использует [PerceiverImagePreprocessor](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (с `prep_type="pixels"`) для предобработки входных изображений, а [PerceiverClassificationDecoder](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) — для декодирования латентного представления [PerceiverModel](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverModel) в логиты классификации.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.PerceiverForImageClassificationFourier.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1219)
**Параметры:**
inputs (`torch.Tensor`, *необязательный*) : Входы для перцептора. Могут быть любыми: изображения, текст, аудио, видео и т. д.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления потерь классификации/регрессии изображений. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels == 1`, вычисляется потеря регрессии (среднеквадратичная потеря), если `config.num_labels > 1`, вычисляется потеря классификации (кросс-энтропия).
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/main/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [PerceiverImageProcessor](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverImageProcessor). Подробности см. в [PerceiverImageProcessor.__call__()](/docs/transformers/main/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [PerceiverImageProcessor](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverImageProcessor) для обработки изображений).
**Возвращает:** [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или `tuple(torch.Tensor)`
Объект [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) и входных данных.
Метод forward класса [PerceiverForImageClassificationFourier](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForImageClassificationFourier) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **cross_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания кросс-внимания декодера, после применения softmax к вниманию, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Примеры:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationFourier
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-fourier")
>>> model = PerceiverForImageClassificationFourier.from_pretrained("deepmind/vision-perceiver-fourier")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForImageClassificationConvProcessing[[transformers.PerceiverForImageClassificationConvProcessing]]
#### transformers.PerceiverForImageClassificationConvProcessing[[transformers.PerceiverForImageClassificationConvProcessing]]
```python
transformers.PerceiverForImageClassificationConvProcessing(config: PerceiverConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1310)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Пример использования Perceiver для классификации изображений, например, для задач типа ImageNet.
Эта модель использует 2D-сеть предобработки conv+maxpool. Как показано в статье, эта модель может достичь точности top-1 82,1 на ImageNet.
[PerceiverForImageClassificationLearned](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) использует [PerceiverImagePreprocessor](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (с `prep_type="conv"`) для предобработки входных изображений, а [PerceiverClassificationDecoder](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) — для декодирования латентного представления [PerceiverModel](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverModel) в логиты классификации.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.PerceiverForImageClassificationConvProcessing.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1343)
**Параметры:**
inputs (`torch.Tensor`, *необязательный*) : Входы для перцептора. Могут быть любыми: изображения, текст, аудио, видео и т. д.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления потерь классификации/регрессии изображений. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels == 1`, вычисляется потеря регрессии (среднеквадратичная потеря), если `config.num_labels > 1`, вычисляется потеря классификации (кросс-энтропия).
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/main/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [PerceiverImageProcessor](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverImageProcessor). Подробности см. в [PerceiverImageProcessor.__call__()](/docs/transformers/main/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) (`processor_class` использует [PerceiverImageProcessor](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverImageProcessor) для обработки изображений).
**Возвращает:** [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или `tuple(torch.Tensor)`
Объект [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) и входных данных.
Метод forward класса [PerceiverForImageClassificationConvProcessing](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForImageClassificationConvProcessing) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **cross_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания кросс-внимания декодера, после применения softmax к вниманию, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Примеры:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationConvProcessing
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-conv")
>>> model = PerceiverForImageClassificationConvProcessing.from_pretrained("deepmind/vision-perceiver-conv")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForOpticalFlow[[transformers.PerceiverForOpticalFlow]]
#### transformers.PerceiverForOpticalFlow[[transformers.PerceiverForOpticalFlow]]
```python
transformers.PerceiverForOpticalFlow(config: PerceiverConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1434)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Пример использования Perceiver для оценки оптического потока в задачах, таких как Sintel и KITTI. [PerceiverForOpticalFlow](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForOpticalFlow) использует [PerceiverImagePreprocessor](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (с *prep_type="patches"*) для предобработки входных изображений, а [PerceiverOpticalFlowDecoder](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder) — для декодирования латентного представления [PerceiverModel](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverModel).
В качестве входных данных два последовательных кадра конкатенируются вдоль размерности каналов, и для каждого пикселя извлекается патч 3 x 3 (что приводит к 3 x 3 x 3 x 2 = 54 значениям для каждого пикселя). Для кодирования позиции каждого пикселя в патче используются фиксированные Фурье-позиционные кодирования. Далее применяется Perceiver-энкодер. Для декодирования латентное представление опрашивается с использованием того же кодирования, что и для входных данных.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.PerceiverForOpticalFlow.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1484)
**Параметры:**
inputs (`torch.Tensor`, *необязательный*) : Входы для перцептора. Могут быть любыми: изображения, текст, аудио, видео и т. д.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления функции потерь оптического потока. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`.
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/main/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
**Возвращает:** [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или `tuple(torch.Tensor)`
Объект [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) и входных данных.
Метод forward класса [PerceiverForOpticalFlow](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForOpticalFlow) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **cross_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания кросс-внимания декодера, после применения softmax к вниманию, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Примеры:
```python
>>> from transformers import PerceiverForOpticalFlow
>>> import torch
>>> model = PerceiverForOpticalFlow.from_pretrained("deepmind/optical-flow-perceiver")
>>> # in the Perceiver IO paper, the authors extract a 3 x 3 patch around each pixel,
>>> # leading to 3 x 3 x 3 = 27 values for each pixel (as each pixel also has 3 color channels)
>>> # patches have shape (batch_size, num_frames, num_channels, height, width)
>>> # the authors train on resolutions of 368 x 496
>>> patches = torch.randn(1, 2, 27, 368, 496)
>>> outputs = model(inputs=patches)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 368, 496, 2]
```
## PerceiverForMultimodalAutoencoding[[transformers.PerceiverForMultimodalAutoencoding]]
#### transformers.PerceiverForMultimodalAutoencoding[[transformers.PerceiverForMultimodalAutoencoding]]
```python
transformers.PerceiverForMultimodalAutoencoding(config: PerceiverConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1576)
**Параметры:**
config ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Пример использования Perceiver для мультимодального (видео) автокодирования, например, для задач на датасете Kinetics-700.
[PerceiverForMultimodalAutoencoding](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding) использует [PerceiverMultimodalPreprocessor](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor) для предобработки трёх модальностей: изображений, аудио и классовых меток. Этот предобработчик применяет специфичные для каждой модальности предобработчики, чтобы обработать каждую модальность отдельно, после чего результаты конкатенируются. Обучаемые позиционные эмбеддинги используются для дополнения каждой модальности до одинакового числа каналов, что позволяет выполнить конкатенацию по временному измерению. Далее применяется Perceiver-энкодер.
[PerceiverMultimodalDecoder](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder) используется для декодирования латентного представления [PerceiverModel](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverModel). Этот декодер использует декодеры, специфичные для каждого модальности, для построения запросов. Запросы декодера создаются на основе входных данных после предобработки. Однако автокодирование всего видео за один прямой проход вычислительно неосуществимо, поэтому для кросс-внимания с латентным представлением используются только части запросов декодера. Это определяется подвыборкой индексов для каждой модальности, которые могут быть переданы как дополнительный вход для прямого прохода [PerceiverForMultimodalAutoencoding](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding).
[PerceiverMultimodalDecoder](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder) также дополняет декодерные запросы различных модальностей до одинакового числа каналов, чтобы склеить их вдоль временного измерения. Далее выполняется кросс-внимание с латентным представлением [PerceiverModel](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverModel).
Наконец, `~models.perceiver.modeling_perceiver.PerceiverMultiModalPostprocessor` используется для преобразования этого тензора в фактическое видео. Сначала он разделяет вывод на различные модальности, а затем применяет соответствующий постпроцессор для каждой модальности.
Обратите внимание, что при маскировке метки классификации во время оценки (то есть при передаче тензора нулей для модальности «label») эта модель автокодирования становится классификатором видео Kinetics 700.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.PerceiverForMultimodalAutoencoding.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, subsampled_output_points: dict[str, torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1692)
**Параметры:**
inputs (`torch.Tensor`, *необязательный*) : Входы для перцептора. Могут быть любыми: изображения, текст, аудио, видео и т. д.
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
subsampled_output_points (`dict[str, torch.Tensor]`, *необязательный*) : Словарь тензоров, используемых в качестве запросов для декодера. Декодер отображает эти запросы на латентное представление модели. Используется для декодирования с подвыборкой, например, когда декодируются только определённые участки изображения.
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
labels (`torch.LongTensor` формы `(batch_size,)`, *необязательный*) : Метки для вычисления потерь классификации/регрессии изображений. Индексы должны находиться в диапазоне `[0, ..., config.num_labels - 1]`. Если `config.num_labels == 1`, вычисляется потеря регрессии (среднеквадратичная потеря), если `config.num_labels > 1`, вычисляется потеря классификации (кросс-энтропия).
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/main/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
**Возвращает:** [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или `tuple(torch.Tensor)`
Объект [PerceiverClassifierOutput](/docs/transformers/main/ru/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([PerceiverConfig](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverConfig)) и входных данных.
Метод forward класса [PerceiverForMultimodalAutoencoding](/docs/transformers/main/ru/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если задан `labels`) -- Потери классификации (или регрессии, если config.num_labels==1).
- **logits** (`torch.Tensor` формы `(batch_size, config.num_labels)`) — Оценки классификации (или регрессии, если config.num_labels==1) до применения SoftMax.
- **hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или когда `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **cross_attentions** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания кросс-внимания декодера, после применения softmax к вниманию, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Примеры:
```python
>>> from transformers import PerceiverForMultimodalAutoencoding
>>> import torch
>>> import numpy as np
>>> # create multimodal inputs
>>> images = torch.randn((1, 16, 3, 224, 224))
>>> audio = torch.randn((1, 30720, 1))
>>> inputs = dict(image=images, audio=audio, label=torch.zeros((images.shape[0], 700)))
>>> model = PerceiverForMultimodalAutoencoding.from_pretrained("deepmind/multimodal-perceiver")
>>> # in the Perceiver IO paper, videos are auto-encoded in chunks
>>> # each chunk subsamples different index dimensions of the image and audio modality decoder queries
>>> nchunks = 128
>>> image_chunk_size = np.prod((16, 224, 224)) // nchunks
>>> audio_chunk_size = audio.shape[1] // model.config.samples_per_patch // nchunks
>>> # process the first chunk
>>> chunk_idx = 0
>>> subsampling = {
... "image": torch.arange(image_chunk_size * chunk_idx, image_chunk_size * (chunk_idx + 1)),
... "audio": torch.arange(audio_chunk_size * chunk_idx, audio_chunk_size * (chunk_idx + 1)),
... "label": None,
... }
>>> outputs = model(inputs=inputs, subsampled_output_points=subsampling)
>>> logits = outputs.logits
>>> list(logits["audio"].shape)
[1, 240]
>>> list(logits["image"].shape)
[1, 6272, 3]
>>> list(logits["label"].shape)
[1, 700]
```