# Perceiver
## Aperçu
Le modèle Perceiver IO a été proposé dans [Perceiver IO: A General Architecture for Structured Inputs & Outputs](https://huggingface.co/papers/2107.14795) par Andrew Jaegle, Sebastian Borgeaud, Jean-Baptiste Alayrac, Carl Doersch, Catalin Ionescu, David Ding, Skanda Koppula, Daniel Zoran, Andrew Brock, Evan Shelhamer, Olivier Hénaff, Matthew M. Botvinick, Andrew Zisserman, Oriol Vinyals, João Carreira.
Perceiver IO est une généralisation de [Perceiver](https://huggingface.co/papers/2103.03206) permettant de traiter des sorties arbitraires en plus des entrées arbitraires. Le Perceiver d'origine ne produisait qu'une seule étiquette de classification. En plus des étiquettes de classification, Perceiver IO peut produire (par exemple) du langage, du flux optique et des vidéos multimodales avec audio. Cela est réalisé à l'aide des mêmes briques de base que le Perceiver d'origine. La complexité computationnelle de Perceiver IO est linéaire par rapport à la taille des entrées et des sorties, et la majeure partie du traitement a lieu dans l'espace latent, ce qui nous permet de traiter des entrées et des sorties beaucoup plus grandes que ce que les Transformers standards peuvent gérer. Cela signifie, par exemple, que Perceiver IO peut effectuer un modelage de langage masqué de type BERT directement à l'aide d'octets, au lieu d'entrées tokenisées.
L'abstract de l'article est le suivant :
*Le modèle Perceiver, récemment proposé, obtient de bons résultats dans plusieurs domaines (images, audio, multimodal, nuages de points) tout en passant à l'échelle linéairement en calcul et en mémoire par rapport à la taille de l'entrée. Bien que le Perceiver prenne en charge de nombreux types d'entrées, il ne peut produire que des sorties très simples, telles que des scores de classes. Perceiver IO surmonte cette limitation sans sacrifier les propriétés attrayantes de l'original, en apprenant à interroger de manière flexible l'espace latent du modèle pour produire des sorties de taille et de sémantique arbitraires. Perceiver IO découple toujours la profondeur du modèle de la taille des données et passe toujours à l'échelle linéairement avec la taille des données, mais désormais par rapport aux tailles d'entrée et de sortie. Le modèle Perceiver IO complet obtient de solides résultats sur des tâches avec des espaces de sortie fortement structurés, tels que le langage naturel et la compréhension visuelle, StarCraft II, ainsi que les domaines multi-tâches et multimodaux. À titre d'exemple, Perceiver IO égale un modèle de référence BERT basé sur des Transformers sur le benchmark linguistique GLUE, sans avoir besoin de tokenisation des entrées, et atteint des performances de pointe sur l'estimation du flux optique Sintel.*
Voici un résumé expliquant le fonctionnement de Perceiver :
Le principal problème du mécanisme d'auto-attention du Transformer est que les exigences en temps et en mémoire évoluent de manière quadratique avec la longueur de la séquence. Par conséquent, des modèles comme BERT et RoBERTa sont limités à une longueur de séquence maximale de 512 jetons. Perceiver vise à résoudre ce problème en effectuant l'auto-attention non pas sur les entrées, mais sur un ensemble de variables latentes, et en n'utilisant les entrées que pour l'attention croisée. De cette façon, les exigences en temps et en mémoire ne dépendent plus de la longueur des entrées, car on utilise une quantité fixe de variables latentes, par exemple 256 ou 512. Celles-ci sont initialisées aléatoirement, puis entraînées de bout en bout par rétropropagation.
En interne, [PerceiverModel](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverModel) crée les latents, qui sont un tenseur de forme `(batch_size, num_latents, d_latents)`. Il faut fournir au modèle des `inputs` (qui peuvent être du texte, des images, de l’audio, etc.), qu’il utilisera pour effectuer une attention croisée avec les latents. La sortie de l’encodeur Perceiver est un tenseur de la même forme. On peut ensuite, de manière similaire à BERT, convertir les derniers états cachés des latents en logits de classification en moyennant le long de la dimension de la séquence, puis en plaçant une couche linéaire au-dessus pour projeter les `d_latents` vers `num_labels`.
C’était l’idée du papier original Perceiver. Cependant, il ne pouvait produire que des logits de classification. Dans un travail ultérieur, PerceiverIO, ils l’ont généralisé pour permettre au modèle de générer des sorties de taille arbitraire. Comment, vous demanderez-vous ? L’idée est en réalité relativement simple : on définit des sorties de taille arbitraire, puis on applique une attention croisée avec les derniers états cachés des latents, en utilisant les sorties comme requêtes et les latents comme clés et valeurs.
Supposons que l’on souhaite effectuer du masked language modeling (de type BERT) avec le Perceiver. Comme la longueur d’entrée du Perceiver n’a pas d’impact sur le temps de calcul des couches d’auto-attention, on peut fournir des octets bruts, en transmettant au modèle des `inputs` de longueur 2048. Si l’on masque ensuite certains de ces 2048 jetons, on peut définir les `outputs` comme ayant la forme `(batch_size, 2048, 768)`. Ensuite, on effectue une cross-attention avec les états cachés finaux des latents pour mettre à jour le tenseur `outputs`. Après la cross-attention, on dispose toujours d’un tenseur de forme `(batch_size, 2048, 768)`. On peut alors placer une tête de language modeling classique au-dessus, afin de projeter la dernière dimension sur la taille du vocabulaire du modèle, c’est-à-dire créer des logits de forme `(batch_size, 2048, 262)` (le Perceiver utilisant une taille de vocabulaire de 262 identifiants d’octets).
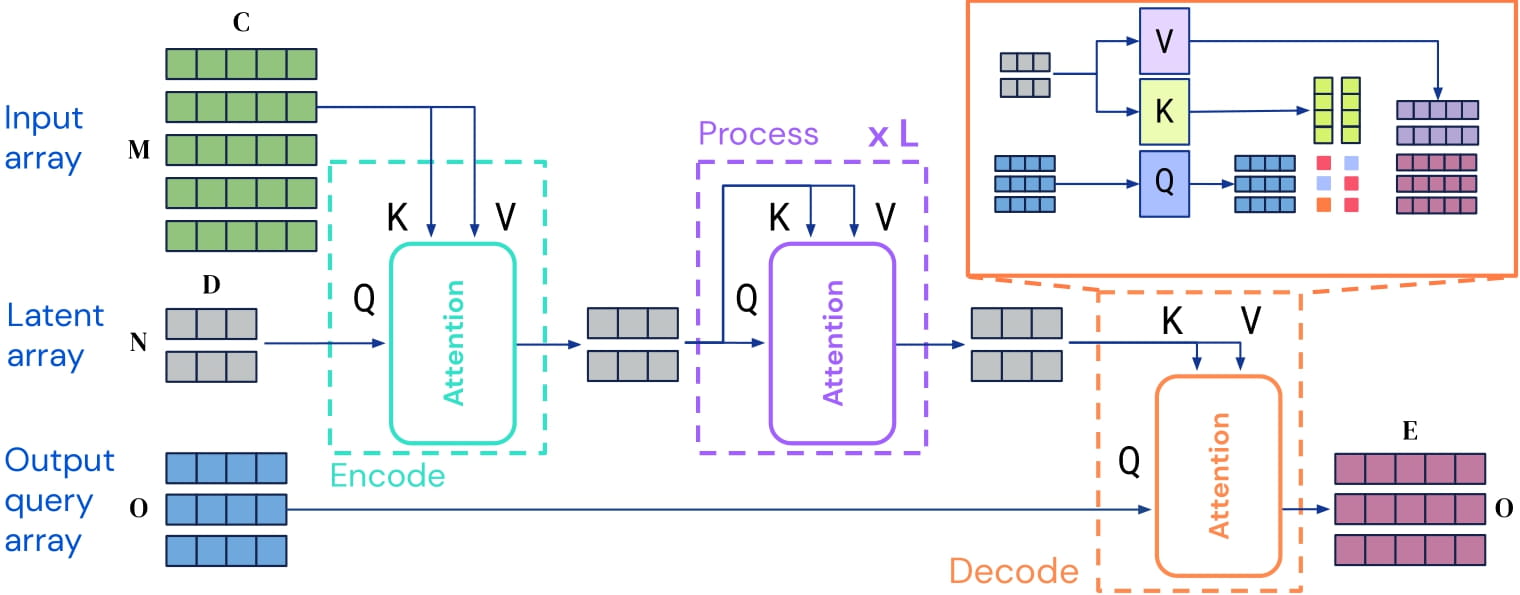 Architecture Perceiver IO. Issue de l'article original
Ce modèle a été contribué par [nielsr](https://huggingface.co/nielsr). Le code d'origine peut être trouvé [ici](https://github.com/deepmind/deepmind-research/tree/master/perceiver).
Perceiver ne **fonctionne pas** avec `torch.nn.DataParallel` en raison d'un bug dans PyTorch, voir [issue #36035](https://github.com/pytorch/pytorch/issues/36035)
## Ressources
- La façon la plus rapide de se familiariser avec le Perceiver est de consulter les [carnets de tutoriel](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Perceiver).
- Consultez le [article de blog](https://huggingface.co/blog/perceiver) si vous souhaitez comprendre en détail le fonctionnement du modèle et
est implémenté dans la bibliothèque. Notez que les modèles disponibles dans la bibliothèque ne présentent que quelques exemples de ce que vous pouvez faire avec le Perceiver. Il existe de nombreux autres cas d’utilisation, notamment le question answering, la reconnaissance d’entités nommées, la détection d’objets, la classification audio, la classification vidéo, etc.
- [Guide de la tâche de classification de texte](../tasks/sequence_classification)
- [Guide de la tâche de modélisation de langage masqué](../tasks/masked_language_modeling)
- [Guide de la tâche de classification d'images](../tasks/image_classification)
## Sorties spécifiques à Perceiver[[transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput(logits: typing.Optional[torch.Tensor] = None, last_hidden_state: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L53)
**Paramètres :**
logits (`torch.Tensor` de forme `(batch_size, num_labels)`) : Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
last_hidden_state (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Séquence d'états cachés à la sortie de la dernière couche du modèle.
hidden_states (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) : Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`. États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d’embedding initiales facultatives.
attentions (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) : Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`. Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
cross_attentions (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) : Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`. Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Classe de base pour les sorties du modèle de base Perceiver, avec états cachés, attentions et attentions croisées potentielles.
#### transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput(logits: typing.Optional[torch.Tensor] = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L72)
**Paramètres :**
logits (`torch.Tensor` de forme `(batch_size, num_labels)`) : Sortie du décodeur de base.
cross_attentions (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) : Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`. Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Classe de base pour les sorties du décodeur Perceiver, avec des cross-attentions potentielles.
#### transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput(loss: typing.Optional[torch.Tensor] = None, logits: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L88)
**Paramètres :**
loss (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) : Perte de modélisation de langage masquée (MLM).
logits (`torch.Tensor` de forme `(batch_size, sequence_length, config.vocab_size)`) : Scores de prédiction de la tête de modélisation du langage (scores pour chaque jeton du vocabulaire avant SoftMax).
hidden_states (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) : Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`. États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d’embedding initiales facultatives.
attentions (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) : Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`. Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
cross_attentions (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) : Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`. Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Classe de base pour les sorties du modèle de langage masqué de Perceiver.
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput(loss: typing.Optional[torch.Tensor] = None, logits: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L110)
**Paramètres :**
loss (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) : perte de classification (ou de régression si config.num_labels==1).
logits (`torch.Tensor` de forme `(batch_size, config.num_labels)`) : Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
hidden_states (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) : Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`. États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d’embedding initiales facultatives.
attentions (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) : Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`. Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
cross_attentions (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) : Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`. Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Classe de base pour les sorties des modèles de classification de séquences/images, de flux optique et d'auto-encodage multimodal de Perceiver.
## PerceiverConfig[[transformers.PerceiverConfig]]
#### transformers.PerceiverConfig[[transformers.PerceiverConfig]]
```python
transformers.PerceiverConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_latents: int = 256, d_latents: int = 1280, d_model: int = 768, num_blocks: int = 1, num_self_attends_per_block: int = 26, num_self_attention_heads: int = 8, num_cross_attention_heads: int = 8, qk_channels: int | None = None, v_channels: int | None = None, cross_attention_shape_for_attention: str = 'kv', self_attention_widening_factor: int = 1, cross_attention_widening_factor: int = 1, hidden_act: str = 'gelu', attention_probs_dropout_prob: float | int = 0.1, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, use_query_residual: bool = True, vocab_size: int = 262, max_position_embeddings: int = 2048, image_size: int | list[int] | tuple[int, int] = 56, train_size: list[int] | tuple[int, ...] = (368, 496), num_frames: int = 16, audio_samples_per_frame: int = 1920, samples_per_patch: int = 16, output_shape: list[int] | tuple[int, ...] = (1, 16, 224, 224), output_num_channels: int = 512, _label_trainable_num_channels: int = 1024)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/configuration_perceiver.py#L24)
**Paramètres :**
num_latents (`int`, *facultatif*, valeur par défaut : 256) : Le nombre de latents.
d_latents (`int`, *facultatif*, par défaut 1280) : Dimension des embeddings latents.
d_model (`int`, *facultatif*, valeur par défaut `768`) : Taille des couches d'encodeur et de la couche pooler.
num_blocks (`int`, *facultatif*, valeur par défaut : 1) : Nombre de blocs dans l'encodeur Transformer.
num_self_attends_per_block (`int`, *facultatif*, valeur par défaut : 26) : Le nombre de couches d'auto-attention par bloc.
num_self_attention_heads (`int`, *facultatif*, valeur par défaut : 8) : Nombre de têtes d'attention pour chaque couche d'auto-attention dans l'encodeur Transformer.
num_cross_attention_heads (`int`, *facultatif*, valeur par défaut : 8) : Nombre de têtes d'attention pour chaque couche d'attention croisée dans l'encodeur Transformer.
qk_channels (`int`, *facultatif*) : Dimension à laquelle projeter les requêtes + clés avant d'appliquer l'attention dans les couches d'attention croisée et d'auto-attention de l'encodeur. Par défaut, la dimension des requêtes est conservée si aucune valeur n'est spécifiée.
v_channels (`int`, *facultatif*) : Dimension à laquelle projeter les valeurs avant d'appliquer l'attention dans les couches d'attention croisée et d'auto-attention de l'encodeur. Par défaut, la dimension des requêtes est conservée si aucune valeur n'est spécifiée.
cross_attention_shape_for_attention (`str`, *facultatif*, valeur par défaut `"kv"`) : Dimension à utiliser lors du sous-échantillonnage des requêtes et des clés dans la couche d'attention croisée de l'encodeur.
self_attention_widening_factor (`int`, *facultatif*, valeur par défaut : 1) : Dimension de la couche feed-forward dans la couche d'attention croisée de l'encodeur Transformer.
cross_attention_widening_factor (`int`, *facultatif*, valeur par défaut : 1) : Dimension de la couche feed-forward dans les couches d'auto-attention de l'encodeur Transformer.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
attention_probs_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.1`) : Le taux de dropout appliqué aux probabilités d'attention.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
layer_norm_eps (`float`, *facultatif*, par défaut `1e-12`) : L'épsilon utilisé par les couches de normalisation par couche.
use_query_residual (`float`, *facultatif*, par défaut `True`) : Indique s'il faut ajouter un résidu de requête dans la couche d'attention croisée de l'encodeur.
vocab_size (`int`, *facultatif*, valeur par défaut `262`) : Taille du vocabulaire du modèle. Définit le nombre de jetons différents qui peuvent être représentés par `input_ids`.
max_position_embeddings (`int`, *facultatif*, valeur par défaut `2048`) : La longueur de séquence maximale avec laquelle ce modèle pourrait être utilisé.
image_size (`int`, *facultatif*, valeur par défaut : 56) : Taille des images après prétraitement, pour [PerceiverForImageClassificationLearned](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned).
train_size (`list[int]`, *facultatif*, par défaut `[368, 496]`) : Taille d'entraînement des images pour le modèle de flux optique.
num_frames (`int`, *facultatif*, valeur par défaut : 16) : Nombre de frames vidéo utilisées par le modèle d'autoencodage multimodal.
audio_samples_per_frame (`int`, *facultatif*, valeur par défaut 1920) : Nombre d'échantillons audio par trame pour le modèle d'auto-encodage multimodal.
samples_per_patch (`int`, *facultatif*, valeur par défaut 16) : Nombre d'échantillons audio par patch lors de la prétraitement de l'audio pour le modèle d'auto-encodage multimodal.
output_shape (`list[int]`, *facultatif*, valeur par défaut `[1, 16, 224, 224]`) : Forme de la sortie (batch_size, num_frames, height, width) pour les requêtes du décodeur vidéo du modèle d'auto-encodage multimodal. Cela exclut la dimension des canaux.
output_num_channels (`int`, *facultatif*, valeur par défaut 512) : Nombre de canaux de sortie pour chaque décodeur de modalité.
Ceci est la classe de configuration destinée à stocker la configuration d'un PerceiverModel. Elle est utilisée pour instancier un modèle Perceiver en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [deepmind/language-perceiver](https://huggingface.co/deepmind/language-perceiver)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import PerceiverModel, PerceiverConfig
>>> # Initializing a Perceiver deepmind/language-perceiver style configuration
>>> configuration = PerceiverConfig()
>>> # Initializing a model from the deepmind/language-perceiver style configuration
>>> model = PerceiverModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## PerceiverTokenizer[[transformers.PerceiverTokenizer]]
#### transformers.PerceiverTokenizer[[transformers.PerceiverTokenizer]]
```python
transformers.PerceiverTokenizer(pad_token = '[PAD]', bos_token = '[BOS]', eos_token = '[EOS]', mask_token = '[MASK]', cls_token = '[CLS]', sep_token = '[SEP]', model_max_length = 2048, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/tokenization_perceiver.py#L23)
**Paramètres :**
pad_token (`str`, *facultatif*, par défaut `"[PAD]"`) : le jeton utilisé pour le bourrage, par exemple lors du groupement de séquences de longueurs différentes.
bos_token (`str`, *facultatif*, par défaut `"[BOS]"`) : le jeton BOS (réservé dans le vocabulaire, mais non réellement utilisé).
eos_token (`str`, *facultatif*, par défaut `"[EOS]"`) : le jeton de fin de séquence (réservé dans le vocabulaire, mais non réellement utilisé). Lors de la construction d'une séquence à l'aide de jetons spéciaux, ce n'est pas ce jeton qui est utilisé pour la fin de séquence. Le jeton utilisé est le `sep_token`.
mask_token (`str`, *facultatif*, par défaut `"[MASK]"`) : le jeton MASK, utile pour le modélisation de langage masquée.
cls_token (`str`, *facultatif*, par défaut `"[CLS]"`) : le jeton CLS (réservé dans le vocabulaire, mais non réellement utilisé).
sep_token (`str`, *facultatif*, par défaut `"[SEP]"`) : le jeton séparateur, utilisé lors de la construction d'une séquence à partir de deux séquences.
Construisez un tokenizer Perceiver. Le Perceiver utilise simplement l'encodage utf-8 des octets bruts.
Ce tokenizer hérite de [PreTrainedTokenizer](/docs/transformers/main/fr/main_classes/tokenizer#transformers.PythonBackend), qui contient la plupart des méthodes principales. Les utilisateurs doivent se reporter à cette superclasse pour plus d’informations sur ces méthodes.
#### __appel__[[transformers.PerceiverTokenizer.__call__]]
```python
__call__(text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, add_special_tokens: bool = True, padding: bool | str | PaddingStrategy = False, truncation: bool | str | TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, is_split_into_words: bool = False, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, tokenizer_kwargs: dict[str, Any] | None = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/tokenization_utils_base.py#L2449)
**Paramètres :**
text (`str`, `list[str]`, `list[list[str]]`, *facultatif*) : La séquence ou le lot de séquences à encoder. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes de caractères (chaînes pré-tokenisées). Si les séquences sont fournies sous forme de liste de chaînes de caractères (pré-tokenisées), vous devez définir `is_split_into_words=True` (pour lever l'ambiguïté avec un lot de séquences).
text_pair (`str`, `list[str]`, `list[list[str]]`, *facultatif*) : La séquence ou le lot de séquences à encoder. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes de caractères (chaînes pré-tokenisées). Si les séquences sont fournies sous forme de liste de chaînes de caractères (pré-tokenisées), vous devez définir `is_split_into_words=True` (pour lever l'ambiguïté avec un lot de séquences).
text_target (`str`, `list[str]`, `list[list[str]]`, *facultatif*) : La séquence ou le lot de séquences à encoder en tant que textes cibles. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes de caractères (chaîne pré-tokenisée). Si les séquences sont fournies sous forme de liste de chaînes de caractères (pré-tokenisées), vous devez définir `is_split_into_words=True` (pour lever l’ambiguïté avec un lot de séquences).
text_pair_target (`str`, `list[str]`, `list[list[str]]`, *facultatif*) : La séquence ou le lot de séquences à encoder en tant que textes cibles. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes de caractères (chaîne pré-tokenisée). Si les séquences sont fournies sous forme de liste de chaînes de caractères (pré-tokenisées), vous devez définir `is_split_into_words=True` (pour lever l’ambiguïté avec un lot de séquences).
tokenizer_kwargs (`dict[str, Any]`, *facultatif*) : kwargs supplémentaires à passer au tokenizer. Ils seront fusionnés avec les paramètres explicites et les autres kwargs, les paramètres explicites ayant la priorité.
add_special_tokens (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter des jetons spéciaux lors de l'encodage des séquences. Cette opération utilise la fonction sous-jacente `PretrainedTokenizerBase.build_inputs_with_special_tokens`, qui définit les jetons ajoutés automatiquement aux identifiants d'entrée. Cela est utile si vous souhaitez ajouter automatiquement des jetons `bos` ou `eos`.
padding (`bool`, `str` ou [PaddingStrategy](/docs/transformers/main/fr/internal/file_utils#transformers.utils.PaddingStrategy), *facultatif*, par défaut `False`) : Active et contrôle le bourrage. Accepte les valeurs suivantes : - `True` ou `'longest'` : Bourrage jusqu'à la séquence la plus longue du lot (ou aucun bourrage si une seule séquence est fournie). - `'max_length'` : Bourrage jusqu'à une longueur maximale spécifiée avec l'argument `max_length` ou jusqu'à la longueur d'entrée maximale acceptable pour le modèle si cet argument n'est pas fourni. - `False` ou `'do_not_pad'` (par défaut) : Aucun bourrage (c'est-à-dire, peut produire un lot avec des séquences de longueurs différentes).
truncation (`bool`, `str` ou [TruncationStrategy](/docs/transformers/main/fr/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *facultatif*, par défaut `False`) : Active et contrôle la troncature. Accepte les valeurs suivantes : - `True` ou `'longest_first'` : Tronque à une longueur maximale spécifiée par l'argument `max_length` ou à la longueur d'entrée maximale acceptable pour le modèle si cet argument n'est pas fourni. Cela tronque jeton par jeton, en supprimant un jeton de la séquence la plus longue de la paire si une paire de séquences (ou un lot de paires) est fournie. - `'only_first'` : Tronque à une longueur maximale spécifiée par l'argument `max_length` ou à la longueur d'entrée maximale acceptable pour le modèle si cet argument n'est pas fourni. Cela ne tronque que la première séquence d'une paire si une paire de séquences (ou un lot de paires) est fournie. - `'only_second'` : Tronque à une longueur maximale spécifiée par l'argument `max_length` ou à la longueur d'entrée maximale acceptable pour le modèle si cet argument n'est pas fourni. Cela ne tronque que la deuxième séquence d'une paire si une paire de séquences (ou un lot de paires) est fournie. - `False` ou `'do_not_truncate'` (par défaut) : Aucune troncature (c'est-à-dire, peut produire un lot avec des longueurs de séquences supérieures à la taille d'entrée maximale admissible du modèle).
max_length (`int`, *facultatif*) : Permet de contrôler la longueur maximale à utiliser par l'un des paramètres de troncature/remplissage. S'il n'est pas défini ou s'il est défini sur `None`, la longueur maximale prédéfinie du modèle sera utilisée si l'un des paramètres de troncature/remplissage exige une longueur maximale. Si le modèle n'a pas de longueur d'entrée maximale spécifique (comme XLNet), la troncature/remplissage à une longueur maximale sera désactivée.
stride (`int`, *facultatif*, valeur par défaut 0) : Si défini avec une valeur numérique en plus de `max_length`, les jetons en dépassement renvoyés lorsque `return_overflowing_tokens=True` contiendront certains jetons de la fin de la séquence tronquée renvoyée, afin d'assurer un chevauchement entre les séquences tronquées et celles en dépassement. La valeur de cet argument définit le nombre de jetons en chevauchement.
is_split_into_words (`bool`, *facultatif*, valeur par défaut `False`) : Indique si l'entrée est déjà pré-tokenisée (par exemple, découpée en mots). Si défini sur `True`, le tokenizer suppose que l'entrée est déjà découpée en mots (par exemple, en la séparant sur les espaces) et procède à sa tokenisation. Cela est utile pour la NER ou la classification de tokens.
pad_to_multiple_of (`int`, *facultatif*) : Si défini, la séquence sera rembourdie jusqu'à un multiple de la valeur fournie. Nécessite l'activation de `padding`. Cela est particulièrement utile pour permettre l'utilisation des Tensor Cores sur le matériel NVIDIA avec une capacité de calcul `>= 7.5` (Volta).
padding_side (`str`, *facultatif*) : Le côté sur lequel le modèle doit appliquer le bourrage. Doit être sélectionné parmi ['right', 'left']. La valeur par défaut est choisie à partir de l'attribut de classe du même nom.
return_tensors (`str` ou [TensorType](/docs/transformers/main/fr/internal/file_utils#transformers.TensorType), *facultatif*) : Si défini, renverra des tenseurs au lieu d'une liste d'entiers Python. Les valeurs acceptables sont : - `'pt'` : Renvoie des objets `torch.Tensor` de PyTorch. - `'np'` : Renvoie des objets `np.ndarray` de Numpy.
return_token_type_ids (`bool`, *facultatif*) : Indique s'il faut renvoyer les identifiants de type de jeton. Si la valeur par défaut est conservée, les identifiants de type de jeton seront renvoyés selon la valeur par défaut du tokeniseur spécifique, définie par l'attribut `return_outputs`. [Qu'est-ce que les identifiants de type de jeton ?](../glossary#token-type-ids)
return_attention_mask (`bool`, *facultatif*) : Indique s'il faut retourner le masque d'attention. Si la valeur par défaut est conservée, le masque d'attention est retourné selon la valeur par défaut du tokenizer spécifique, définie par l'attribut `return_outputs`. [Qu'est-ce que les masques d'attention ?](../glossary#attention-mask)
return_overflowing_tokens (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut ou non renvoyer les séquences de jetons en dépassement. Si une paire de séquences d'identifiants d'entrée (ou un lot de paires) est fournie avec `truncation_strategy = longest_first` ou `True`, une erreur est levée au lieu de renvoyer les jetons en dépassement.
return_special_tokens_mask (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut ou non retourner les informations du masque des jetons spéciaux.
return_offsets_mapping (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut ou non retourner `(char_start, char_end)` pour chaque jeton. Cette option n'est disponible que pour les tokenizers rapides héritant de [PreTrainedTokenizerFast](/docs/transformers/main/fr/main_classes/tokenizer#transformers.TokenizersBackend) ; si vous utilisez le tokenizer Python, cette méthode lèvera `NotImplementedError`.
return_length (`bool`, *facultatif*, par défaut `False`) : Indique s'il faut retourner les longueurs des entrées encodées.
verbose (`bool`, *facultatif*, par défaut `True`) : Indique s'il faut afficher plus d'informations et d'avertissements.
- ****kwargs** : transmis à la méthode `self.tokenize()`
**Retourne :** [BatchEncoding](/docs/transformers/main/fr/main_classes/tokenizer#transformers.BatchEncoding)
Un [BatchEncoding](/docs/transformers/main/fr/main_classes/tokenizer#transformers.BatchEncoding) avec les champs suivants :
- **input_ids** -- Liste des identifiants de jetons à fournir au modèle.
[Qu'est-ce que les identifiants d'entrée ?](../glossary#input-ids)
- **token_type_ids** -- Liste des identifiants de type de jeton à fournir au modèle (lorsque `return_token_type_ids=True` ou si *"token_type_ids"* est présent dans `self.model_input_names`).
[Qu'est-ce que les identifiants de type de jeton ?](../glossary#token-type-ids)
- **attention_mask** -- Liste d'indices spécifiant les jetons auxquels le modèle doit prêter attention (lorsque `return_attention_mask=True` ou si *"attention_mask"* est présent dans `self.model_input_names`).
[Qu'est-ce que les masques d'attention ?](../glossary#attention-mask)
- **overflowing_tokens** -- Liste des séquences de jetons en dépassement (lorsqu'une `max_length` est spécifiée et `return_overflowing_tokens=True`).
- **num_truncated_tokens** -- Nombre de jetons tronqués (lorsqu'une `max_length` est spécifiée et `return_overflowing_tokens=True`).
- **special_tokens_mask** -- Liste de 0 et de 1, où 1 indique les jetons spéciaux ajoutés et 0 indique les jetons de séquence réguliers (lorsque `add_special_tokens=True` et `return_special_tokens_mask=True`).
- **length** -- La longueur des entrées (lorsque `return_length=True`)
Méthode principale pour tokeniser et préparer pour le modèle une ou plusieurs séquences ou une ou plusieurs paires de séquences.
## PerceiverImageProcessor[[transformers.PerceiverImageProcessor]]
#### transformers.PerceiverImageProcessor[[transformers.PerceiverImageProcessor]]
```python
transformers.PerceiverImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/image_processing_perceiver.py#L33)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 224, 'width': 224}`) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 256, 'width': 256}`) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `3`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir de l'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.485, 0.456, 0.406]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.229, 0.224, 0.225]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
Construit un processeur d’images PerceiverImageProcessor.
#### prétraiter[[transformers.PerceiverImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *facultatif*) : Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant qu'argument nommé ne fonctionne pas. Par exemple, `preprocess(images, masks=masks)` est l'option recommandée, mais cela peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas, vous pouvez utiliser à la place `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
## PerceiverImageProcessorPil[[transformers.PerceiverImageProcessorPil]]
#### transformers.PerceiverImageProcessorPil[[transformers.PerceiverImageProcessorPil]]
```python
transformers.PerceiverImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/image_processing_pil_perceiver.py#L31)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 224, 'width': 224}`) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 256, 'width': 256}`) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `3`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir de l'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.485, 0.456, 0.406]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.229, 0.224, 0.225]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
Construit un processeur d’images PerceiverImageProcessor.
#### prétraiter[[transformers.PerceiverImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *facultatif*) : Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant qu'argument nommé ne fonctionne pas. Par exemple, `preprocess(images, masks=masks)` est l'option recommandée, mais cela peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas, vous pouvez utiliser à la place `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
## PerceiverTextPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor(config: PerceiverConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2662)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Configuration du modèle.
Prétraitement du texte pour Perceiver Encoder. Peut être utilisé pour intégrer les `inputs` et ajouter des encodages positionnels.
La dimension des embeddings est déterminée par l'attribut `d_model` de la configuration.
## PerceiverImagePreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor(config, prep_type = 'conv', spatial_downsample: int = 4, temporal_downsample: int = 1, position_encoding_type: str = 'fourier', in_channels: int = 3, out_channels: int = 64, conv_after_patching: bool = False, conv_after_patching_in_channels: int = 54, conv2d_use_batchnorm: bool = True, concat_or_add_pos: str = 'concat', project_pos_dim: int = -1, **position_encoding_kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2825)
**Paramètres :**
config ([*PerceiverConfig*]) : Configuration du modèle.
prep_type (`str`, *facultatif*, valeur par défaut `"conv"`) : Type de prétraitement. Peut être "conv1x1", "conv", "patches", "pixels".
spatial_downsample (`int`, *facultatif*, valeur par défaut : 4) : Facteur de sous-échantillonnage spatial.
temporal_downsample (`int`, *facultatif*, valeur par défaut : 1) : Facteur de sous-échantillonnage temporel (pertinent uniquement si une dimension temporelle est présente).
position_encoding_type (`str`, *facultatif*, par défaut `"fourier"`) : Type d'encodage de position. Peut être "fourier" ou "trainable".
in_channels (`int`, *facultatif*, valeur par défaut 3) : Nombre de canaux dans l'entrée.
out_channels (`int`, *facultatif*, valeur par défaut 64) : Nombre de canaux dans la sortie.
conv_after_patching (`bool`, *facultatif*, par défaut `False`) : Indique s'il faut appliquer une couche de convolution après le patching.
conv_after_patching_in_channels (`int`, *facultatif*, valeur par défaut : 54) : Nombre de canaux dans l'entrée de la couche convolutive après le patching.
conv2d_use_batchnorm (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut utiliser la normalisation par lot dans la couche de convolution.
concat_or_add_pos (`str`, *facultatif*, par défaut `"concat"`) : Méthode de concaténation du codage de position à l'entrée. Peut être "concat" ou "add".
project_pos_dim (`int`, *facultatif*, valeur par défaut : -1) : Dimension de l'encodage de position vers laquelle projeter. Si la valeur est -1, aucune projection n'est appliquée.
- ****position_encoding_kwargs** (`Dict`, *facultatif*) : Arguments par mot-clé pour l'encodage de position.
Prétraitement des images pour Perceiver Encoder.
Remarque : l'argument *out_channels* fait référence aux canaux de sortie d'une couche de convolution, si *prep_type* est défini sur "conv1x1" ou "conv". Si l'on ajoute des embeddings de position absolue, il faut s'assurer que *num_channels* des kwargs de l'encodage de position est égal à *out_channels*.
## PerceiverOneHotPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor(config: PerceiverConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L3063)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Configuration du modèle.
Préprocesseur one-hot pour Perceiver Encoder. Peut être utilisé pour ajouter une dimension d'index factice à l'entrée.
## PerceiverAudioPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor(config, prep_type: str = 'patches', samples_per_patch: int = 96, position_encoding_type: str = 'fourier', concat_or_add_pos: str = 'concat', out_channels = 64, project_pos_dim = -1, **position_encoding_kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L3089)
**Paramètres :**
config ([*PerceiverConfig*]) : Configuration du modèle.
prep_type (`str`, *facultatif*, valeur par défaut `"patches"`) : Type de préprocesseur à utiliser. Seul "patches" est pris en charge.
samples_per_patch (`int`, *facultatif*, valeur par défaut : 96) : Nombre d'échantillons par patch.
position_encoding_type (`str`, *facultatif*, valeur par défaut `"fourier"`) : Type d'encodage de position à utiliser. Peut être "trainable" ou "fourier".
concat_or_add_pos (`str`, *facultatif*, par défaut `"concat"`) : Méthode de concaténation du codage de position à l'entrée. Peut être "concat" ou "add".
out_channels (`int`, *facultatif*, valeur par défaut 64) : Nombre de canaux dans la sortie.
project_pos_dim (`int`, *facultatif*, valeur par défaut : -1) : Dimension de l'encodage de position vers laquelle projeter. Si la valeur est -1, aucune projection n'est appliquée.
- ****position_encoding_kwargs** (`Dict`, *facultatif*) : Arguments par mot-clé pour l'encodage de position.
Prétraitement audio pour Perceiver Encoder.
## PerceiverMultimodalPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor(modalities: Mapping, mask_probs: collections.abc.Mapping[str, float] | None = None, min_padding_size: int = 2)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L3192)
**Paramètres :**
modalities (`Mapping[str, PreprocessorType]`) : Dictionnaire associant le nom de la modalité au préprocesseur.
mask_probs (`dict[str, float]`) : Dictionnaire associant le nom de la modalité à la probabilité de masquage de cette modalité.
min_padding_size (`int`, *facultatif*, valeur par défaut : 2) : La taille minimale de bourrage pour toutes les modalités. La sortie finale aura un nombre de canaux (num_channels) égal au nombre maximal de canaux parmi toutes les modalités, plus min_padding_size.
Prétraitement multimodal pour Perceiver Encoder.
Les entrées de chaque modalité sont prétraitées, puis remplies avec des embeddings de position entraînables afin d’obtenir le même nombre de canaux.
## PerceiverProjectionDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder(config)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1839)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Configuration du modèle.
Décodeur de projection de référence (sans attention croisée).
## PerceiverBasicDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder(config: PerceiverConfig, output_num_channels: int, position_encoding_type: str | None = 'trainable', output_index_dims: int | None = None, num_channels: int | None = 128, subsampled_index_dims: int | None = None, qk_channels: int | None = None, v_channels: int | None = None, num_heads: int | None = 1, widening_factor: int | None = 1, use_query_residual: bool | None = False, concat_preprocessed_input: bool | None = False, final_project: bool | None = True, position_encoding_only: bool | None = False, **position_encoding_kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1863)
**Paramètres :**
config ([*PerceiverConfig*]) : Configuration du modèle.
output_num_channels (`int`, *facultatif*) : Le nombre de canaux dans la sortie. N'est utilisé que si *final_project* est défini sur `True`.
position_encoding_type (`str`, *facultatif*, valeur par défaut "trainable") : Le type d'encodage de position à utiliser. Peut être "trainable", "fourier" ou "none".
output_index_dims (`int`, *facultatif*) : Le nombre de dimensions des requêtes de sortie. Ignoré si 'position_encoding_type' == 'none'.
num_channels (`int`, *facultatif*, valeur par défaut 128) : Le nombre de canaux des requêtes du décodeur. Ignoré si 'position_encoding_type' == 'none'.
qk_channels (`int`, *facultatif*) : Le nombre de canaux des requêtes et des clés dans la couche d'attention croisée.
v_channels (`int`, *facultatif*) : Le nombre de canaux des valeurs dans la couche d'attention croisée.
num_heads (`int`, *facultatif*, valeur par défaut : 1) : Le nombre de têtes d'attention dans la couche d'attention croisée.
widening_factor (`int`, *facultatif*, valeur par défaut : 1) : Le facteur d'élargissement de la couche d'attention croisée.
use_query_residual (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut utiliser une connexion résiduelle entre la requête et la sortie de la couche d'attention croisée.
concat_preprocessed_input (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut concaténer l'entrée prétraitée à la requête.
final_project (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut projeter la sortie de la couche d'attention croisée vers une dimension cible.
position_encoding_only (`bool`, *facultatif*, par défaut `False`) : Indique s'il faut utiliser cette classe uniquement pour définir les requêtes de sortie.
Décodeur basé sur l'attention croisée. Cette classe peut être utilisée pour décoder les états cachés finaux des latents à l'aide d'une opération d'attention croisée, dans laquelle les latents produisent les clés et les valeurs.
La forme de la sortie de cette classe dépend de la manière dont on définit les requêtes de sortie (également appelées requêtes du décodeur).
## PerceiverClassificationDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder(config, **decoder_kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2048)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Configuration du modèle.
Décodeur de classification basé sur l'attention croisée. Enveloppe légère de `PerceiverBasicDecoder` pour la sortie de logits. Convertit la sortie de l'encodeur Perceiver, de forme (batch_size, num_latents, d_latents), en un tenseur de forme (batch_size, num_labels). Les requêtes sont de forme (batch_size, 1, num_labels).
## PerceiverOpticalFlowDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder(config, output_image_shape, output_num_channels = 2, rescale_factor = 100.0, **decoder_kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2094)
Décodeur de flux optique basé sur l'attention croisée.
## PerceiverBasicVideoAutoencodingDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder(config: PerceiverConfig, output_shape: list, position_encoding_type: str, **decoder_kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2129)
**Paramètres :**
config ([*PerceiverConfig*]) : Configuration du modèle.
output_shape (`list[int]`) : Forme de la sortie en tant que (batch_size, num_frames, height, width), en excluant la dimension des canaux.
position_encoding_type (`str`) : Le type d'encodage de position à utiliser. Peut être "trainable", "fourier" ou "none".
Décodeur de vidéo auto-encodage basé sur l'attention croisée. Enveloppe légère de [*PerceiverBasicDecoder*] avec une logique de remodelage de la vidéo.
## PerceiverMultimodalDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder(config: PerceiverConfig, modalities: dict, num_outputs: int, output_num_channels: int, min_padding_size: int | None = 2, subsampled_index_dims: dict[str, transformers.models.perceiver.modeling_perceiver.PerceiverAbstractDecoder] | None = None, **decoder_kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2206)
**Paramètres :**
config ([*PerceiverConfig*]) : Configuration du modèle.
modalities (`dict[str, PerceiverAbstractDecoder]`) : Dictionnaire associant le nom de la modalité au décodeur de cette modalité.
num_outputs (`int`) : Le nombre de sorties du décodeur.
output_num_channels (`int`) : Le nombre de canaux dans la sortie.
min_padding_size (`int`, *facultatif*, valeur par défaut : 2) : La taille minimale de bourrage pour toutes les modalités. La sortie finale aura un nombre de canaux (num_channels) égal au nombre maximal de canaux parmi toutes les modalités, plus min_padding_size.
subsampled_index_dims (`dict[str, PerceiverAbstractDecoder]`, *facultatif*) : Dictionnaire associant le nom de la modalité aux dimensions d'index sous-échantillonnées à utiliser pour la requête du décodeur de cette modalité.
Décodage multimodal par composition de décodeurs unimodaux. L'argument *modalities* du constructeur est un dictionnaire associant le nom d'une modalité au décodeur de cette modalité. Ce décodeur est utilisé pour construire les requêtes de la modalité concernée. Les requêtes spécifiques à chaque modalité sont remplies (padding) avec des paramètres spécifiques à la modalité et entraînables, puis concaténées le long de la dimension temporelle.
Ensuite, il y a une opération d'attention croisée partagée entre toutes les modalités.
## PerceiverProjectionPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor(in_channels: int, out_channels: int)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2804)
**Paramètres :**
in_channels (`int`) : Nombre de canaux dans l'entrée.
out_channels (`int`) : Nombre de canaux dans la sortie.
Post-traitement de la projection pour Perceiver. Peut être utilisé pour projeter les canaux de la sortie du décodeur vers une dimension inférieure.
## PerceiverAudioPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor(config: PerceiverConfig, in_channels: int, postproc_type: str = 'patches')
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2777)
**Paramètres :**
config ([*PerceiverConfig*]) : Configuration du modèle.
in_channels (`int`) : Nombre de canaux dans l'entrée.
postproc_type (`str`, *facultatif*, par défaut `"patches"`) : Type de postprocesseur à utiliser. Actuellement, seul "patches" est pris en charge.
Post-traitement audio pour Perceiver. Peut être utilisé pour convertir la sortie du décodeur en caractéristiques audio.
## PerceiverClassificationPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor(config: PerceiverConfig, in_channels: int)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2757)
**Paramètres :**
config ([*PerceiverConfig*]) : Configuration du modèle.
in_channels (`int`) : Nombre de canaux dans l'entrée.
Post-traitement de la classification pour Perceiver. Peut être utilisé pour convertir la sortie du décodeur en logits de classification.
## PerceiverMultimodalPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor(modalities: Mapping, input_is_dict: bool = False)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L2723)
**Paramètres :**
modalities (`Mapping[str, PostprocessorType]`) : Dictionnaire associant le nom de la modalité à la classe de postprocesseur pour cette modalité.
input_is_dict (`bool`, *facultatif*, valeur par défaut `False`) : Si True, l'entrée est supposée avoir une structure de dictionnaire, et les sorties conservent la même forme de dictionnaire. Si False, l'entrée est un tenseur qui est découpé pendant le post-traitement par *modality_sizes*.
Post-traitement multimodal pour Perceiver. Peut être utilisé pour combiner des post-processeurs spécifiques à chaque modalité en un seul post-processeur.
## PerceiverModel[[transformers.PerceiverModel]]
#### transformers.PerceiverModel[[transformers.PerceiverModel]]
```python
transformers.PerceiverModel(config: PerceiverConfig, decoder: typing.Optional[ForwardRef('PerceiverAbstractDecoder')] = None, input_preprocessor: Callable = None, output_postprocessor: Callable = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L561)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
decoder (`PerceiverDecoder`, *facultatif*) : Module de décodage qui transforme les représentations latentes en prédictions de tâche.
input_preprocessor (`PreprocessorType`, *facultatif*) : Préprocesseur qui encode les entrées brutes en tenseurs pour le modèle.
output_postprocessor (`PostprocessorType`, *facultatif*) : Postprocesseur qui transforme les sorties du modèle en prédictions finales.
Le Perceiver : une architecture entièrement attentionnelle et évolutive.
Notez qu’il est possible d’affiner Perceiver sur des images de résolution supérieure à celles utilisées pour son entraînement, en définissant `interpolate_pos_encoding` sur `True` dans le forward du modèle. Cela permet d’interpoler les embeddings de position pré-entraînés à la résolution plus élevée.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.PerceiverModel.forward]]
```python
forward(inputs: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, subsampled_output_points: dict[str, torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, interpolate_pos_encoding: bool = False, return_dict: bool | None = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L597)
**Paramètres :**
inputs (`torch.Tensor`) : Entrées du perceiver. Peut être n'importe quoi : images, texte, audio, vidéo, etc.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
subsampled_output_points (`dict[str, torch.Tensor]`, *facultatif*) : Dictionnaire de tenseurs utilisés en tant que requêtes pour le décodeur. Le décodeur associe ces requêtes à la représentation latente du modèle. Utilisé pour le décodage sous-échantillonné, par exemple lors du décodage de certains patches d'image uniquement.
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
**Retourne :** [PerceiverModelOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput) ou `tuple(torch.Tensor)`
Un [PerceiverModelOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) et les entrées.
La méthode forward du [PerceiverModel](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **logits** (`torch.Tensor` de forme `(batch_size, num_labels)`) -- Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Exemples :
```python
>>> from transformers import PerceiverConfig, PerceiverTokenizer, PerceiverImageProcessor, PerceiverModel
>>> from transformers.models.perceiver.modeling_perceiver import (
... PerceiverTextPreprocessor,
... PerceiverImagePreprocessor,
... PerceiverClassificationDecoder,
... )
>>> import torch
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> # EXAMPLE 1: using the Perceiver to classify texts
>>> # - we define a TextPreprocessor, which can be used to embed tokens
>>> # - we define a ClassificationDecoder, which can be used to decode the
>>> # final hidden states of the latents to classification logits
>>> # using trainable position embeddings
>>> config = PerceiverConfig()
>>> preprocessor = PerceiverTextPreprocessor(config)
>>> decoder = PerceiverClassificationDecoder(
... config,
... num_channels=config.d_latents,
... trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
... use_query_residual=True,
... )
>>> model = PerceiverModel(config, input_preprocessor=preprocessor, decoder=decoder)
>>> # you can then do a forward pass as follows:
>>> tokenizer = PerceiverTokenizer()
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> with torch.no_grad():
... outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()
>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
>>> # EXAMPLE 2: using the Perceiver to classify images
>>> # - we define an ImagePreprocessor, which can be used to embed images
>>> config = PerceiverConfig(image_size=224)
>>> preprocessor = PerceiverImagePreprocessor(
... config,
... prep_type="conv1x1",
... spatial_downsample=1,
... out_channels=256,
... position_encoding_type="trainable",
... concat_or_add_pos="concat",
... project_pos_dim=256,
... trainable_position_encoding_kwargs=dict(
... num_channels=256,
... index_dims=config.image_size**2,
... ),
... )
>>> model = PerceiverModel(
... config,
... input_preprocessor=preprocessor,
... decoder=PerceiverClassificationDecoder(
... config,
... num_channels=config.d_latents,
... trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
... use_query_residual=True,
... ),
... )
>>> # you can then do a forward pass as follows:
>>> image_processor = PerceiverImageProcessor()
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(image, return_tensors="pt").pixel_values
>>> with torch.no_grad():
... outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()
>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
```
## PerceiverForMaskedLM[[transformers.PerceiverForMaskedLM]]
#### transformers.PerceiverForMaskedLM[[transformers.PerceiverForMaskedLM]]
```python
transformers.PerceiverForMaskedLM(config: PerceiverConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L807)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Exemple d'utilisation de Perceiver pour le masquage de modélisation de langage.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.PerceiverForMaskedLM.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, input_ids: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L839)
**Paramètres :**
inputs (`torch.Tensor`, *facultatif*) : Entrées du perceiver. Peut être n'importe quoi : images, texte, audio, vidéo, etc.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
labels (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Étiquettes pour le calcul de la perte de modélisation de langage masquée. Les indices doivent être dans `[-100, 0, ..., config.vocab_size]` (voir la docstring de `input_ids`). Les jetons dont l'indice est défini sur `-100` sont ignorés (masqués) ; la perte n'est calculée que pour les jetons dont l'étiquette est dans `[0, ..., config.vocab_size]`.
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
input_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
**Retourne :** [PerceiverMaskedLMOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput) ou `tuple(torch.Tensor)`
Un [PerceiverMaskedLMOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) et les entrées.
La méthode forward de [PerceiverForMaskedLM](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForMaskedLM) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de modélisation de langage masquée (MLM).
- **logits** (`torch.Tensor` de forme `(batch_size, sequence_length, config.vocab_size)`) -- Scores de prédiction de la tête de modélisation du langage (scores pour chaque jeton du vocabulaire avant SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Exemples :
```python
>>> from transformers import AutoTokenizer, PerceiverForMaskedLM
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForMaskedLM.from_pretrained("deepmind/language-perceiver")
>>> # training
>>> text = "This is an incomplete sentence where some words are missing."
>>> inputs = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask " missing."
>>> inputs["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> labels = tokenizer(text, padding="max_length", return_tensors="pt").input_ids
>>> outputs = model(**inputs, labels=labels)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
19.87
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]
>>> # inference
>>> text = "This is an incomplete sentence where some words are missing."
>>> encoding = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask bytes corresponding to " missing.". Note that the model performs much better if the masked span starts with a space.
>>> encoding["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]
>>> masked_tokens_predictions = logits[0, 52:61].argmax(dim=-1).tolist()
>>> tokenizer.decode(masked_tokens_predictions)
' missing.'
```
## PerceiverForSequenceClassification[[transformers.PerceiverForSequenceClassification]]
#### transformers.PerceiverForSequenceClassification[[transformers.PerceiverForSequenceClassification]]
```python
transformers.PerceiverForSequenceClassification(config: PerceiverConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L940)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Exemple d'utilisation de Perceiver pour la classification de texte.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.PerceiverForSequenceClassification.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, input_ids: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L961)
**Paramètres :**
inputs (`torch.Tensor`, *facultatif*) : Entrées du perceiver. Peut être n'importe quoi : images, texte, audio, vidéo, etc.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
labels (`torch.LongTensor` de forme `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte de classification/régression. Les indices doivent être dans `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1`, une perte de régression est calculée (perte du carré moyen). Si `config.num_labels > 1`, une perte de classification est calculée (entropie croisée).
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
input_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
**Retourne :** [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Un [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) et les entrées.
La méthode forward de [PerceiverForSequenceClassification](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForSequenceClassification) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de classification (ou de régression si config.num_labels==1).
- **logits** (`torch.Tensor` de forme `(batch_size, config.num_labels)`) -- Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Exemples :
```python
>>> from transformers import AutoTokenizer, PerceiverForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForSequenceClassification.from_pretrained("deepmind/language-perceiver")
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
```
## PerceiverForImageClassificationLearned[[transformers.PerceiverForImageClassificationLearned]]
#### transformers.PerceiverForImageClassificationLearned[[transformers.PerceiverForImageClassificationLearned]]
```python
transformers.PerceiverForImageClassificationLearned(config: PerceiverConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1062)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Exemple d'utilisation de Perceiver pour la classification d'images, pour des tâches telles qu'ImageNet.
Ce modèle utilise des embeddings de position appris. Autrement dit, ce modèle ne reçoit aucune information privilégiée sur la structure des images. Comme indiqué dans l’article, ce modèle peut atteindre une précision top-1 de 72,7 sur ImageNet.
[PerceiverForImageClassificationLearned](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) utilise [PerceiverImagePreprocessor](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (avec `prep_type="conv1x1"`) pour prétraiter les images d’entrée, et [PerceiverClassificationDecoder](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) pour décoder la représentation latente de [PerceiverModel](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverModel) en logits de classification.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.PerceiverForImageClassificationLearned.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1093)
**Paramètres :**
inputs (`torch.Tensor`, *facultatif*) : Entrées du perceiver. Peut être n'importe quoi : images, texte, audio, vidéo, etc.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
labels (`torch.LongTensor` de forme `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte de classification/régression d'image. Les indices doivent être dans `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1`, une perte de régression est calculée (perte du carré moyen). Si `config.num_labels > 1`, une perte de classification est calculée (entropie croisée).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [PerceiverImageProcessor](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverImageProcessor). Voir [PerceiverImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [PerceiverImageProcessor](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverImageProcessor) pour le traitement des images).
**Retourne :** [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Un [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) et les entrées.
La méthode forward de [PerceiverForImageClassificationLearned](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de classification (ou de régression si config.num_labels==1).
- **logits** (`torch.Tensor` de forme `(batch_size, config.num_labels)`) -- Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Exemples :
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationLearned
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-learned")
>>> model = PerceiverForImageClassificationLearned.from_pretrained("deepmind/vision-perceiver-learned")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForImageClassificationFourier[[transformers.PerceiverForImageClassificationFourier]]
#### transformers.PerceiverForImageClassificationFourier[[transformers.PerceiverForImageClassificationFourier]]
```python
transformers.PerceiverForImageClassificationFourier(config: PerceiverConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1187)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Exemple d'utilisation de Perceiver pour la classification d'images, pour des tâches telles qu'ImageNet.
Ce modèle utilise des embeddings de position 2D de Fourier fixes. Comme indiqué dans l’article, ce modèle peut atteindre une précision top-1 de 79,0 sur ImageNet, et 84,5 lorsqu’il est pré-entraîné sur un jeu de données à grande échelle (c.-à-d. JFT).
[PerceiverForImageClassificationLearned](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) utilise [PerceiverImagePreprocessor](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (avec `prep_type="pixels"`) pour prétraiter les images d’entrée, et [PerceiverClassificationDecoder](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) pour décoder la représentation latente de [PerceiverModel](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverModel) en logits de classification.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.PerceiverForImageClassificationFourier.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1219)
**Paramètres :**
inputs (`torch.Tensor`, *facultatif*) : Entrées du perceiver. Peut être n'importe quoi : images, texte, audio, vidéo, etc.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
labels (`torch.LongTensor` de forme `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte de classification/régression d'image. Les indices doivent être dans `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1`, une perte de régression est calculée (perte du carré moyen). Si `config.num_labels > 1`, une perte de classification est calculée (entropie croisée).
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [PerceiverImageProcessor](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverImageProcessor). Voir [PerceiverImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [PerceiverImageProcessor](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverImageProcessor) pour le traitement des images).
**Retourne :** [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Un [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) et les entrées.
La méthode forward de [PerceiverForImageClassificationFourier](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForImageClassificationFourier) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de classification (ou de régression si config.num_labels==1).
- **logits** (`torch.Tensor` de forme `(batch_size, config.num_labels)`) -- Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Exemples :
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationFourier
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-fourier")
>>> model = PerceiverForImageClassificationFourier.from_pretrained("deepmind/vision-perceiver-fourier")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForImageClassificationConvProcessing[[transformers.PerceiverForImageClassificationConvProcessing]]
#### transformers.PerceiverForImageClassificationConvProcessing[[transformers.PerceiverForImageClassificationConvProcessing]]
```python
transformers.PerceiverForImageClassificationConvProcessing(config: PerceiverConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1310)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Exemple d'utilisation de Perceiver pour la classification d'images, pour des tâches telles qu'ImageNet.
Ce modèle utilise un réseau de prétraitement conv+maxpool 2D. Comme indiqué dans l'article, ce modèle peut atteindre une précision top-1 de 82,1 sur ImageNet.
[PerceiverForImageClassificationLearned](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned) utilise [PerceiverImagePreprocessor](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (avec `prep_type="conv"`) pour prétraiter les images d’entrée, et [PerceiverClassificationDecoder](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder) pour décoder la représentation latente de [PerceiverModel](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverModel) en logits de classification.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.PerceiverForImageClassificationConvProcessing.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1343)
**Paramètres :**
inputs (`torch.Tensor`, *facultatif*) : Entrées du perceiver. Peut être n'importe quoi : images, texte, audio, vidéo, etc.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
labels (`torch.LongTensor` de forme `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte de classification/régression d'image. Les indices doivent être dans `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1`, une perte de régression est calculée (perte du carré moyen). Si `config.num_labels > 1`, une perte de classification est calculée (entropie croisée).
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [PerceiverImageProcessor](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverImageProcessor). Voir [PerceiverImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [PerceiverImageProcessor](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverImageProcessor) pour le traitement des images).
**Retourne :** [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Un [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) et les entrées.
La méthode forward de [PerceiverForImageClassificationConvProcessing](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForImageClassificationConvProcessing) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de classification (ou de régression si config.num_labels==1).
- **logits** (`torch.Tensor` de forme `(batch_size, config.num_labels)`) -- Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Exemples :
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationConvProcessing
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-conv")
>>> model = PerceiverForImageClassificationConvProcessing.from_pretrained("deepmind/vision-perceiver-conv")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForOpticalFlow[[transformers.PerceiverForOpticalFlow]]
#### transformers.PerceiverForOpticalFlow[[transformers.PerceiverForOpticalFlow]]
```python
transformers.PerceiverForOpticalFlow(config: PerceiverConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1434)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Exemple d'utilisation de Perceiver pour le flux optique, pour des tâches telles que Sintel et KITTI. [PerceiverForOpticalFlow](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForOpticalFlow) utilise [PerceiverImagePreprocessor](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor) (avec *prep_type="patches"*) pour prétraiter les images d'entrée, et [PerceiverOpticalFlowDecoder](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder) pour décoder la représentation latente de [PerceiverModel](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverModel).
En entrée, on concatène 2 images consécutives le long de la dimension des canaux et on extrait un patch de 3 x 3 autour de chaque pixel (ce qui donne 3 x 3 x 3 x 2 = 54 valeurs pour chaque pixel). Des encodages de position de Fourier fixes sont utilisés pour encoder la position de chaque pixel dans le patch. Ensuite, on applique l'encodeur Perceiver. Pour décoder, on interroge la représentation latente en utilisant le même encodage que celui utilisé pour l'entrée.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.PerceiverForOpticalFlow.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1484)
**Paramètres :**
inputs (`torch.Tensor`, *facultatif*) : Entrées du perceiver. Peut être n'importe quoi : images, texte, audio, vidéo, etc.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
labels (`torch.LongTensor` de forme `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte du flux optique. Les indices doivent être dans `[0, ..., config.num_labels - 1]`.
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
**Retourne :** [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Un [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) et les entrées.
La méthode forward de [PerceiverForOpticalFlow](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForOpticalFlow) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de classification (ou de régression si config.num_labels==1).
- **logits** (`torch.Tensor` de forme `(batch_size, config.num_labels)`) -- Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Exemples :
```python
>>> from transformers import PerceiverForOpticalFlow
>>> import torch
>>> model = PerceiverForOpticalFlow.from_pretrained("deepmind/optical-flow-perceiver")
>>> # in the Perceiver IO paper, the authors extract a 3 x 3 patch around each pixel,
>>> # leading to 3 x 3 x 3 = 27 values for each pixel (as each pixel also has 3 color channels)
>>> # patches have shape (batch_size, num_frames, num_channels, height, width)
>>> # the authors train on resolutions of 368 x 496
>>> patches = torch.randn(1, 2, 27, 368, 496)
>>> outputs = model(inputs=patches)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 368, 496, 2]
```
## PerceiverForMultimodalAutoencoding[[transformers.PerceiverForMultimodalAutoencoding]]
#### transformers.PerceiverForMultimodalAutoencoding[[transformers.PerceiverForMultimodalAutoencoding]]
```python
transformers.PerceiverForMultimodalAutoencoding(config: PerceiverConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1576)
**Paramètres :**
config ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Exemple d'utilisation de Perceiver pour l'auto-encodage multimodal (vidéo), pour des tâches telles que Kinetics-700.
[PerceiverForMultimodalAutoencoding](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding) utilise [PerceiverMultimodalPreprocessor](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor) pour prétraiter les trois modalités : images, audio et étiquettes de classes. Ce préprocesseur emploie des préprocesseurs spécifiques à chaque modalité pour traiter chaque modalité séparément, avant de les concaténer. Des embeddings de position entraînables sont utilisés pour rembourrer chaque modalité afin d’atteindre le même nombre de canaux, ce qui permet la concaténation le long de la dimension temporelle. Ensuite, on applique l’encodeur Perceiver.
[PerceiverMultimodalDecoder](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder) est utilisé pour décoder la représentation latente de [PerceiverModel](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverModel). Ce décodeur utilise chaque décodeur spécifique à une modalité pour construire des requêtes. Les requêtes du décodeur sont créées à partir des entrées après prétraitement. Toutefois, l'auto-encodage d'une vidéo entière en un seul passage avant est computationnellement irréalisable ; on n'utilise donc que des parties des requêtes du décodeur pour effectuer l'attention croisée avec la représentation latente. Cela est déterminé par les indices sous-échantillonnés pour chaque modalité, qui peuvent être fournis en tant qu'entrée supplémentaire au passage avant de [PerceiverForMultimodalAutoencoding](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding).
[PerceiverMultimodalDecoder](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder) remplit également les requêtes du décodeur des différentes modalités jusqu'au même nombre de canaux, afin de les concaténer le long de la dimension temporelle. Ensuite, une attention croisée est effectuée avec la représentation latente de [PerceiverModel](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverModel).
Enfin, `~models.perceiver.modeling_perceiver.PerceiverMultiModalPostprocessor` est utilisé pour convertir ce tenseur en vidéo réelle. Il commence par diviser la sortie en différentes modalités, puis applique le postprocesseur correspondant à chaque modalité.
Notez que, en masquant l'étiquette de classification lors de l'évaluation (c'est-à-dire en fournissant simplement un tenseur de zéros pour la modalité « label »), ce modèle d'auto-encodage devient un classifieur de vidéos Kinetics 700.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.PerceiverForMultimodalAutoencoding.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, subsampled_output_points: dict[str, torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/perceiver/modeling_perceiver.py#L1692)
**Paramètres :**
inputs (`torch.Tensor`, *facultatif*) : Entrées du perceiver. Peut être n'importe quoi : images, texte, audio, vidéo, etc.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
subsampled_output_points (`dict[str, torch.Tensor]`, *facultatif*) : Dictionnaire de tenseurs utilisés en tant que requêtes pour le décodeur. Le décodeur associe ces requêtes à la représentation latente du modèle. Utilisé pour le décodage sous-échantillonné, par exemple lors du décodage de certains patches d'image uniquement.
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
labels (`torch.LongTensor` de forme `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte de classification/régression d'image. Les indices doivent être dans `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1`, une perte de régression est calculée (perte du carré moyen). Si `config.num_labels > 1`, une perte de classification est calculée (entropie croisée).
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
**Retourne :** [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou `tuple(torch.Tensor)`
Un [PerceiverClassifierOutput](/docs/transformers/main/fr/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([PerceiverConfig](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverConfig)) et les entrées.
La méthode forward de [PerceiverForMultimodalAutoencoding](/docs/transformers/main/fr/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de classification (ou de régression si config.num_labels==1).
- **logits** (`torch.Tensor` de forme `(batch_size, config.num_labels)`) -- Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax).
- **hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **cross_attentions** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention de la couche d'attention croisée du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention croisée.
Exemples :
```python
>>> from transformers import PerceiverForMultimodalAutoencoding
>>> import torch
>>> import numpy as np
>>> # create multimodal inputs
>>> images = torch.randn((1, 16, 3, 224, 224))
>>> audio = torch.randn((1, 30720, 1))
>>> inputs = dict(image=images, audio=audio, label=torch.zeros((images.shape[0], 700)))
>>> model = PerceiverForMultimodalAutoencoding.from_pretrained("deepmind/multimodal-perceiver")
>>> # in the Perceiver IO paper, videos are auto-encoded in chunks
>>> # each chunk subsamples different index dimensions of the image and audio modality decoder queries
>>> nchunks = 128
>>> image_chunk_size = np.prod((16, 224, 224)) // nchunks
>>> audio_chunk_size = audio.shape[1] // model.config.samples_per_patch // nchunks
>>> # process the first chunk
>>> chunk_idx = 0
>>> subsampling = {
... "image": torch.arange(image_chunk_size * chunk_idx, image_chunk_size * (chunk_idx + 1)),
... "audio": torch.arange(audio_chunk_size * chunk_idx, audio_chunk_size * (chunk_idx + 1)),
... "label": None,
... }
>>> outputs = model(inputs=inputs, subsampled_output_points=subsampling)
>>> logits = outputs.logits
>>> list(logits["audio"].shape)
[1, 240]
>>> list(logits["image"].shape)
[1, 6272, 3]
>>> list(logits["label"].shape)
[1, 700]
```